Přednáška 0 — Vyhledávání
Umělá inteligence
Umělá inteligence (AI) zahrnuje řadu technik, které u počítače působí jako inteligentní chování. AI se například používá k rozpoznávání obličejů na fotografiích na sociálních sítích, k poražení mistra světa v šachu a ke zpracování vaší řeči, když mluvíte se Siri nebo Alexou v telefonu.
V tomto kurzu prozkoumáme některé myšlenky, které umožňují fungování AI:
- Vyhledávání
Hledání řešení problému — například když navigace hledá nejlepší cestu z výchozího místa do cíle nebo když při hraní hry zvažujeme další tah.
- Znalosti
Reprezentace informací a odvozování závěrů z nich.
- Nejistota
Práce s nejistými událostmi pomocí pravděpodobnosti.
- Optimalizace
Hledání způsobu řešení, který je nejen správný, ale lepší — případně nejlepší.
- Učení
Zlepšování výkonu díky přístupu k datům a zkušenostem. E-mail například dokáže na základě minulých zkušeností odlišovat spam od běžné pošty.
- Neuronové sítě
Struktura programu inspirovaná lidským mozkem, která dokáže účinně plnit úkoly.
- Jazyk
Zpracování přirozeného jazyka, který lidé používají a kterému rozumějí.
Vyhledávání
V úlohách vyhledávání dostane agent počáteční a cílový stav a vrátí řešení, jak se dostat z prvního do druhého. Navigační aplikace používá typický proces vyhledávání: agent, tedy rozhodovací část programu, dostane jako vstup vaši současnou polohu a požadovaný cíl a podle vyhledávacího algoritmu navrhne cestu. Existuje však mnoho dalších vyhledávacích úloh, například hlavolamy nebo bludiště.
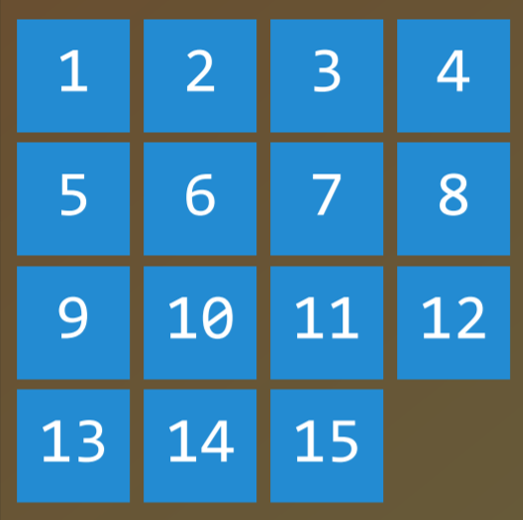
K nalezení řešení patnáctkového hlavolamu bychom potřebovali vyhledávací algoritmus.
-
Agent
Entita, která vnímá své prostředí a působí na ně. V navigaci by například agent představoval automobil, který musí rozhodnout, jaké akce provést, aby dorazil do cíle.
-
Stav
Konfigurace agenta v jeho prostředí. U patnáctkového hlavolamu je například stav jedním konkrétním rozmístěním všech čísel na hrací desce.
-
Počáteční stav
Stav, ze kterého vyhledávací algoritmus začíná. V navigaci by to byla současná poloha.
-
-
Akce
Možnosti, které lze v daném stavu zvolit. Přesněji lze akce definovat funkcí. Když jako vstup dostane stav
s, vrátíActions(s)množinu akcí, které lze ve stavusprovést. U patnáctkového hlavolamu jde o možnosti posunutí políček v současné konfiguraci: čtyři, pokud je prázdné políčko uprostřed, tři, pokud je u okraje, a dvě, pokud je v rohu. -
Přechodový model
Popis toho, jaký stav vznikne provedením libovolné přípustné akce v libovolném stavu. Přesněji lze přechodový model definovat funkcí: dostane-li stav
sa akcia, vrátíResults(s, a)stav vzniklý provedením akceave stavus. Například posunutím políčka v některém směru (akcea) ve známé konfiguraci patnáctkového hlavolamu (stavs) vznikne nová konfigurace, tedy nový stav. -
Stavový prostor
Množina všech stavů dosažitelných z počátečního stavu libovolnou posloupností akcí. U patnáctkového hlavolamu se stavový prostor skládá ze všech 16!/2 konfigurací desky dosažitelných z libovolného počátečního stavu. Stavový prostor lze zobrazit jako orientovaný graf: stavy jsou uzly a akce jsou šipky mezi uzly.
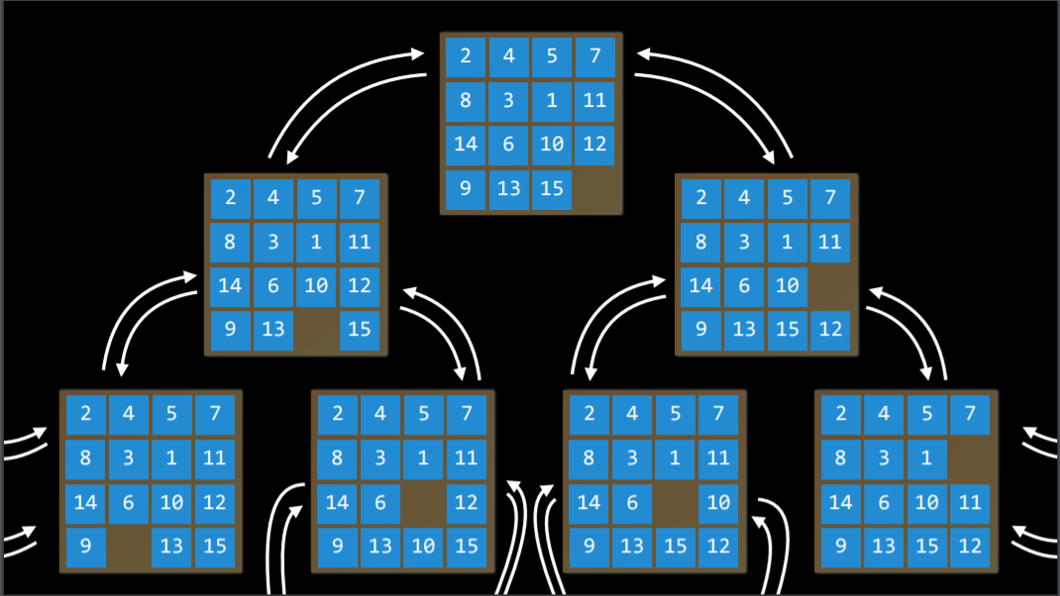
-
Test cíle
Podmínka, která určuje, zda je daný stav cílový. V navigaci bychom například ověřovali, zda současná poloha agenta, tedy reprezentovaného automobilu, odpovídá cíli. Pokud ano, problém je vyřešen. Pokud ne, pokračujeme v hledání.
-
Cena cesty
Číselná cena spojená s určitou cestou. Navigace vás například nejen dovede do cíle, ale snaží se přitom minimalizovat cenu cesty, tedy najít co nejrychlejší cestu do cílového stavu.
Řešení vyhledávacích úloh
-
Řešení
Posloupnost akcí, která vede z počátečního stavu do cílového stavu.
-
Optimální řešení
Řešení s nejnižší cenou cesty mezi všemi řešeními.
-
V procesu vyhledávání se data často ukládají do uzlu, datové struktury obsahující následující údaje:
- Stav
- Jeho rodičovský uzel, ze kterého současný uzel vznikl
- Akci, kterou jsme ve stavu rodiče provedli, abychom dospěli k současnému uzlu
- Cenu cesty z počátečního stavu k tomuto uzlu
Uzly obsahují informace užitečné pro vyhledávací algoritmy. Obsahují stav, který lze zkontrolovat testem cíle a zjistit, zda je konečný. Pokud ano, lze cenu cesty k uzlu porovnat s cenami cest k jiným uzlům a vybrat optimální řešení. Jakmile je uzel vybrán, díky uloženému rodičovskému uzlu a akci vedoucí od rodiče k současnému uzlu lze zpětně projít všechny kroky od počátečního stavu až k tomuto uzlu. Tato posloupnost akcí tvoří řešení.
Uzly jsou však pouze datová struktura: samy nevyhledávají, pouze uchovávají informace. K vlastnímu hledání používáme frontier, tedy hranici prohledávání, která uzly spravuje. Na začátku obsahuje počáteční stav; množina již prozkoumaných položek je prázdná. Potom až do nalezení řešení opakujeme následující postup:
Opakujte:
-
Pokud je hranice prohledávání prázdná,
- Zastavte se. Problém nemá řešení.
-
Odeberte z hranice prohledávání jeden uzel. Tímto uzlem se budeme dále zabývat.
-
Pokud uzel obsahuje cílový stav,
- Vraťte řešení. Zastavte se.
Jinak,
* Rozviňte uzel (najděte všechny nové uzly, do kterých se lze z tohoto uzlu dostat), a přidejte výsledné uzly do hranice hledání.
* Přidejte aktuální uzel do množiny prozkoumaných uzlů.
Vyhledávání do hloubky
V předchozím popisu hranice prohledávání jsme jednu věc vynechali. Který uzel má být odebrán ve druhém kroku uvedeného pseudokódu? Volba ovlivňuje kvalitu řešení i rychlost jeho nalezení. Existuje více možností, jak určit, kterými uzly se zabývat nejdříve. Dvě z nich odpovídají datovým strukturám zásobník při vyhledávání do hloubky a fronta při vyhledávání do šířky; rozdíl ukazuje také tato názorná animace.
Začneme přístupem vyhledávání do hloubky (DFS).
Algoritmus vyhledávání do hloubky zcela prozkoumá jeden směr, než zkusí další. Hranice prohledávání se v tomto případě spravuje jako zásobník. Zapamatujte si pravidlo „poslední dovnitř, první ven“ (last-in first-out). Po přidání uzlů na hranici se jako první odebere a prozkoumá poslední přidaný uzel. Algoritmus tedy postupuje co nejhlouběji v prvním směru, na který narazí, a ostatní směry nechává na později.
(Příklad nad rámec přednášky: představte si, že hledáte klíče. Při vyhledávání do hloubky byste po rozhodnutí začít v kalhotách nejprve prošli všechny kapsy, každou vyprázdnili a pečlivě prozkoumali její obsah. Kalhoty byste přestali prohledávat a přešli jinam teprve po důkladném prozkoumání každé jejich kapsy.)
- Výhody:
- V nejlepším případě je tento algoritmus nejrychlejší. Pokud má štěstí a náhodou vždy zvolí správnou cestu, vyhledávání do hloubky dospěje k řešení v nejkratším možném čase.
- Nevýhody:
- Nalezené řešení nemusí být optimální.
- V nejhorším případě algoritmus před nalezením řešení prozkoumá každou možnou cestu, a potřebuje tak nejdelší možnou dobu.
Ukázka kódu:
    # Define the function that removes a node from the frontier and returns it.
    def remove(self):
    	  # Terminate the search if the frontier is empty, because this means that there is no solution.
        if self.empty():
            raise Exception("empty frontier")
        else:
        	  # Save the last item in the list (which is the newest node added)
            node = self.frontier[-1]
            # Save all the items on the list besides the last node (i.e. removing the last node)
            self.frontier = self.frontier[:-1]
            return node
Vyhledávání do šířky
Opačným přístupem k vyhledávání do hloubky je vyhledávání do šířky (BFS).
Algoritmus vyhledávání do šířky postupuje více směry současně: v každém možném směru udělá jeden krok, než v kterémkoli směru udělá druhý. Hranice prohledávání se zde spravuje jako fronta. Zapamatujte si pravidlo „první dovnitř, první ven“ (first-in first-out). Nové uzly se řadí do fronty a zpracovávají se podle pořadí přidání: kdo přišel první, je obsloužen první. Algoritmus tedy udělá jeden krok v každém možném směru, než v některém udělá druhý.
(Příklad nad rámec přednášky: představte si opět hledání klíčů. Začnete-li kalhotami, podíváte se do pravé kapsy. Potom však místo levé kapsy prohledáte jednu zásuvku, následně stůl a tak dále všechna místa, která vás napadnou. Teprve když projdete všechna tato místa, vrátíte se ke kalhotám a další kapse.)
- Výhody:
- Tento algoritmus zaručeně najde optimální řešení.
- Nevýhody:
- Doba běhu tohoto algoritmu bude téměř jistě delší než nejkratší možná doba.
- V nejhorším případě algoritmus potřebuje nejdelší možnou dobu běhu.
Ukázka kódu:
    # Define the function that removes a node from the frontier and returns it.
    def remove(self):
    	  # Terminate the search if the frontier is empty, because this means that there is no solution.
        if self.empty():
            raise Exception("empty frontier")
        else:
            # Save the oldest item on the list (which was the first one to be added)
            node = self.frontier[0]
            # Save all the items on the list besides the first one (i.e. removing the first node)
            self.frontier = self.frontier[1:]
            return node
Hladové vyhledávání nejlepšího uzlu
Vyhledávání do šířky i do hloubky jsou neinformované vyhledávací algoritmy. Nevyužívají žádnou znalost o problému, kterou nezískaly vlastním prozkoumáváním. Často však nějaké další znalosti skutečně máme. Když například člověk řešící bludiště přijde na křižovatku, vidí, kterým směrem přibližně leží cíl a kterým ne. Totéž může dělat AI. Algoritmus, který přihlíží k dalším znalostem a snaží se tak zvýšit svůj výkon, označujeme jako informovaný.
Hladové vyhledávání nejlepšího uzlu (greedy best-first) rozvíjí uzel, který je podle heuristické funkce h(n) nejblíže cíli. Funkce odhaduje, jak blízko cíle je příští uzel, může se však mýlit. Účinnost tohoto algoritmu závisí na kvalitě heuristiky. V bludišti lze například použít heuristiku založenou na manhattanské vzdálenosti mezi možnými uzly a koncem bludiště. Manhattanská vzdálenost ignoruje zdi a počítá počet kroků nahoru, dolů nebo do stran potřebných pro přesun z určitého místa do cíle. Tento jednoduchý odhad lze odvodit ze souřadnic (x, y) současného místa a cíle.
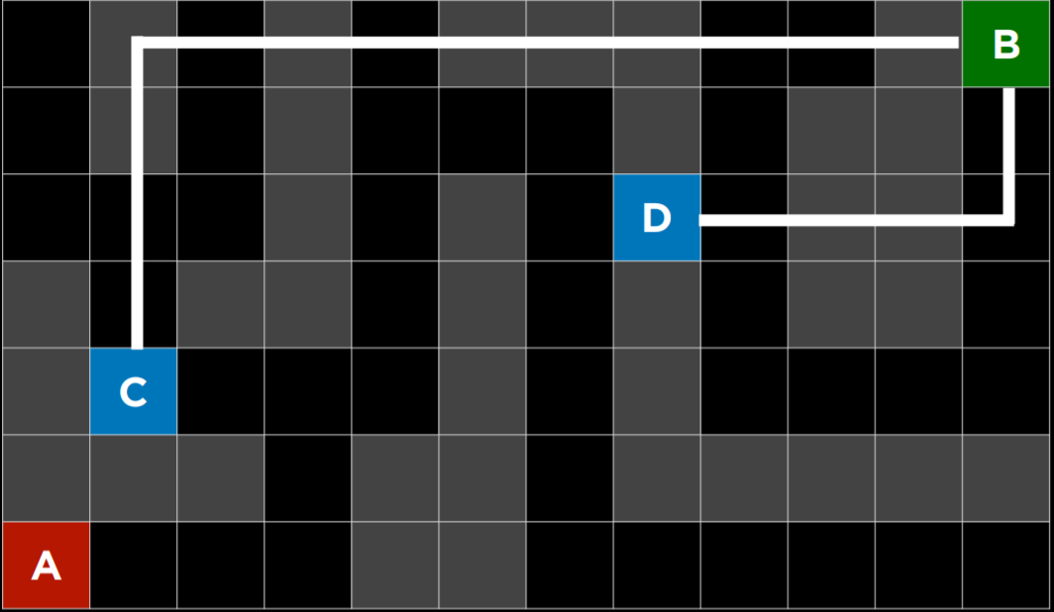
Manhattanská vzdálenost
Je však důležité zdůraznit, že stejně jako každá heuristika může i tato selhat a zavést algoritmus na pomalejší cestu, než jakou by jinak zvolil. Neinformovaný algoritmus může nalézt lepší řešení rychleji; oproti informovanému algoritmu je to však méně pravděpodobné.
Vyhledávání A*
Vyhledávání A* rozvíjí přístup greedy best-first: zvažuje nejen h(n), tedy odhad zbývající ceny do cíle, ale i g(n), cenu již uražené cesty. Spojením obou hodnot může lépe určovat cenu řešení a průběžně optimalizovat volby. Sleduje součet dosavadní ceny cesty a odhadované ceny do cíle. Jakmile součet převýší odhad ceny jiné dřívější možnosti, opustí současnou cestu a vrátí se k této možnosti. Tím se brání postupu po dlouhé a neefektivní cestě, kterou h(n) chybně označila za nejlepší.
Také tento algoritmus závisí na heuristice, takže jeho kvalita odpovídá kvalitě použitého odhadu. V některých situacích může být méně efektivní než greedy best-first, nebo dokonce než neinformované algoritmy. Aby bylo vyhledávání A* optimální, musí heuristická funkce h(n) splňovat tyto vlastnosti:
- Přípustnost: nikdy nesmí nadhodnocovat skutečnou cenu; a
- Konzistenci: odhad ceny zbývající cesty z nového uzlu plus cena přechodu z předchozího uzlu musí být alespoň stejně velký jako odhad zbývající ceny z předchozího uzlu. Formálně je h(n) konzistentní, pokud pro každý uzel n, jeho následníka n’ a cenu kroku c platí h(n) ≤ h(n’) + c.
Vyhledávání proti soupeři
Dosud jsme zkoumali algoritmy hledající odpověď na otázku. Při vyhledávání proti soupeři (adversarial search) však algoritmus čelí soupeři, který usiluje o opačný cíl. AI s tímto typem vyhledávání často potkáme ve hrách, například v piškvorkách.
Minimax
Minimax, jeden z algoritmů vyhledávání proti soupeři, reprezentuje výhru hodnotou (-1) pro jednu stranu a (+1) pro druhou. Další akce se řídí těmito hodnotami: minimalizující strana usiluje o co nejnižší skóre a maximalizující strana o co nejvyšší.
Reprezentace AI pro piškvorky:
- S₀: Počáteční stav (v našem případě prázdná deska 3 × 3)
- Players(s): funkce, která pro daný stav s vrátí hráče na tahu (X nebo O).
- Actions(s): funkce, která pro daný stav s vrátí všechny přípustné tahy (volná políčka na desce).
- Result(s, a): funkce, která pro stav s a akci a vrátí nový stav: desku vzniklou provedením akce a ve stavu s, tedy zahráním tahu.
- Terminal(s): funkce, která pro stav s zkontroluje, zda hra skončila výhrou nebo remízou. Pokud skončila, vrátí True, jinak False.
- Utility(s): funkce, která pro konečný stav s vrátí hodnotu užitku tohoto stavu: -1, 0 nebo 1.
Jak algoritmus funguje:
Algoritmus rekurzivně simuluje všechny možné hry, které mohou proběhnout od současného stavu až do konečného stavu. Každému konečnému stavu přidělí hodnotu (-1), 0 nebo (+1).
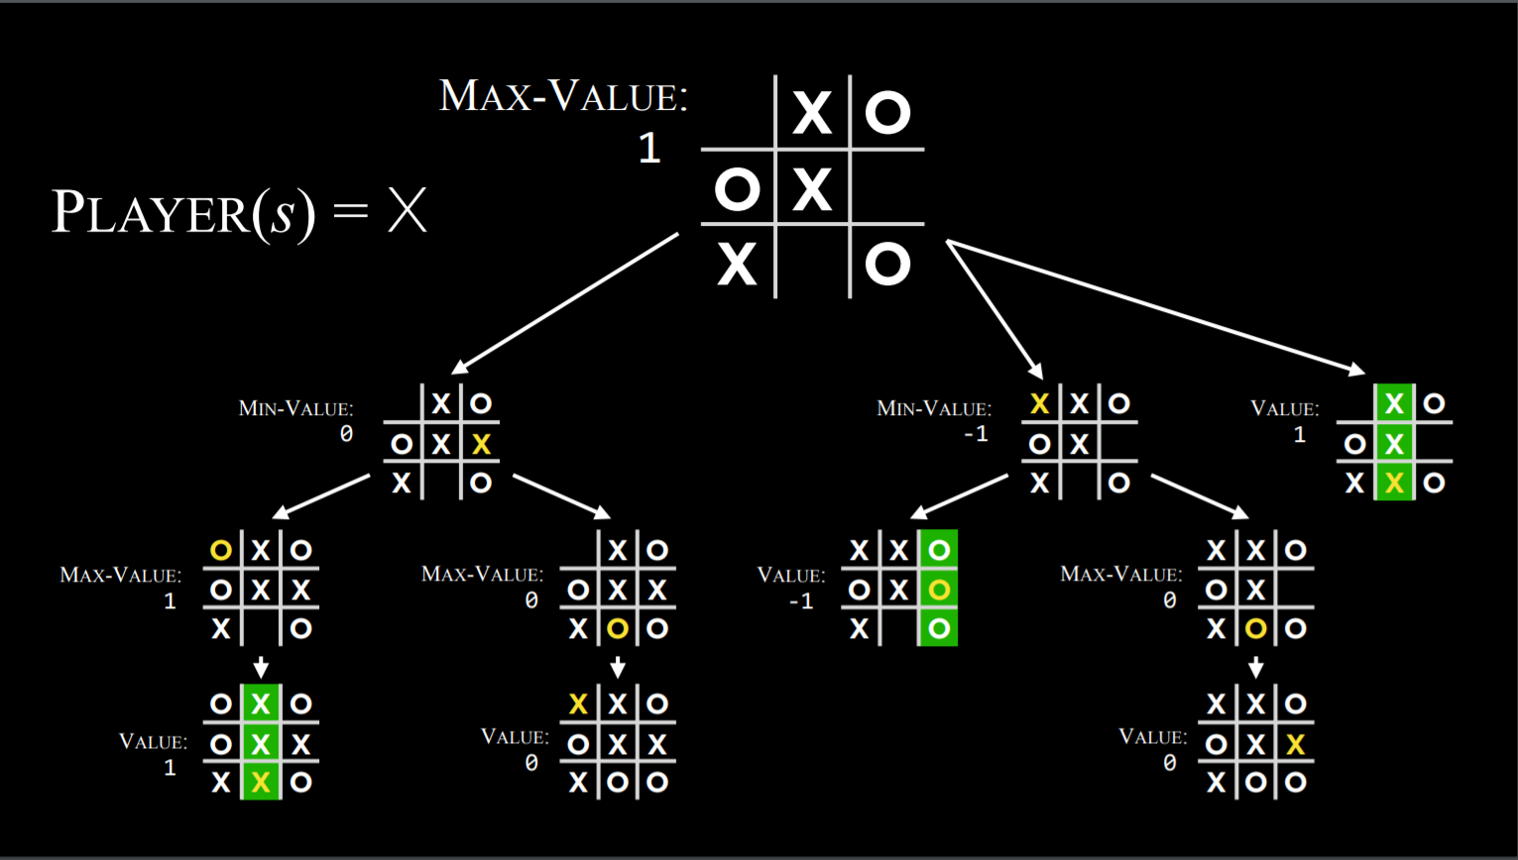
Algoritmus minimax v piškvorkách
Podle toho, kdo je v daném stavu na tahu, algoritmus ví, zda optimálně hrající hráč zvolí akci vedoucí k nižší, nebo vyšší hodnotě stavu. Střídáním minimalizace a maximalizace tak ohodnocuje stavy vzniklé jednotlivými možnými akcemi. Představme si konkrétně, že se maximalizující hráč při každém tahu ptá: „Když provedu tuto akci, vznikne nový stav. Jakou akci může optimálně hrající minimalizující soupeř zvolit, aby dosáhl nejnižší hodnoty?“ K odpovědi se však maximalizující hráč musí ptát dále: „Abych věděl, co udělá minimalizující soupeř, musím simulovat stejný proces v jeho mysli. Soupeř se totiž bude ptát: ‚Když provedu tuto akci, jakou akci může zvolit maximalizující hráč, aby dosáhl nejvyšší hodnoty?‘“ Jde o rekurzivní proces, který může být obtížné pochopit; pomoci může níže uvedený pseudokód. Touto rekurzivní úvahou maximalizující hráč nakonec ohodnotí všechny stavy, které mohou vzniknout z možných akcí, a vybere nejvyšší hodnotu.
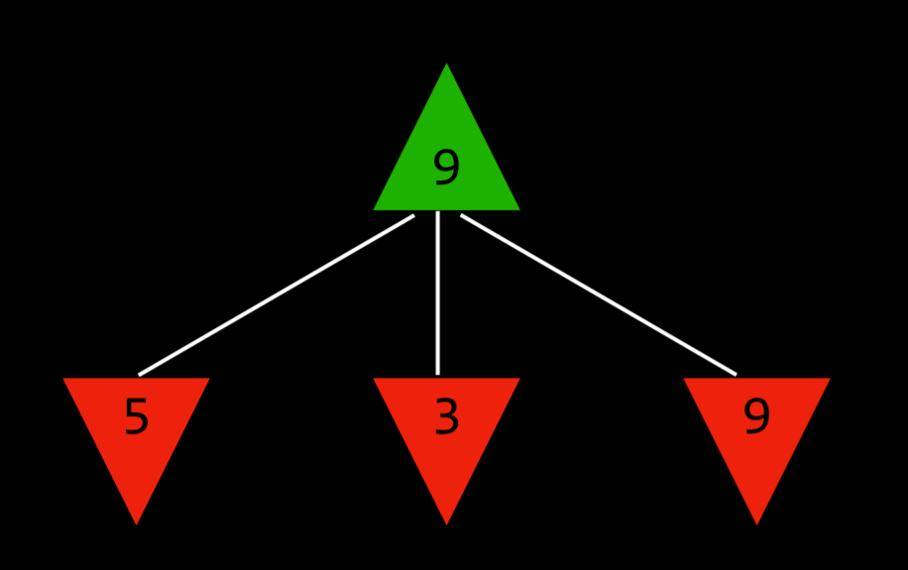
Maximalizující hráč zvažuje možné hodnoty budoucích stavů.
V pseudokódu algoritmus minimax funguje takto:
-
Je dán stav s
- Maximalizující hráč vybere akci a z Actions(s), která dává nejvyšší hodnotu Min-Value(Result(s, a)).
- Minimalizující hráč vybere akci a z Actions(s), která dává nejnižší hodnotu Max-Value(Result(s, a)).
-
Funkce Max-Value(state)
-
v = -∞
-
if Terminal(state):
return Utility(state)
-
for action in Actions(state):
v = Max(v, Min-Value(Result(state, action)))
return v
-
-
Funkce Min-Value(state):
-
v = ∞
-
if Terminal(state):
return Utility(state)
-
for action in Actions(state):
v = Min(v, Max-Value(Result(state, action)))
return v
-
Prořezávání alfa–beta
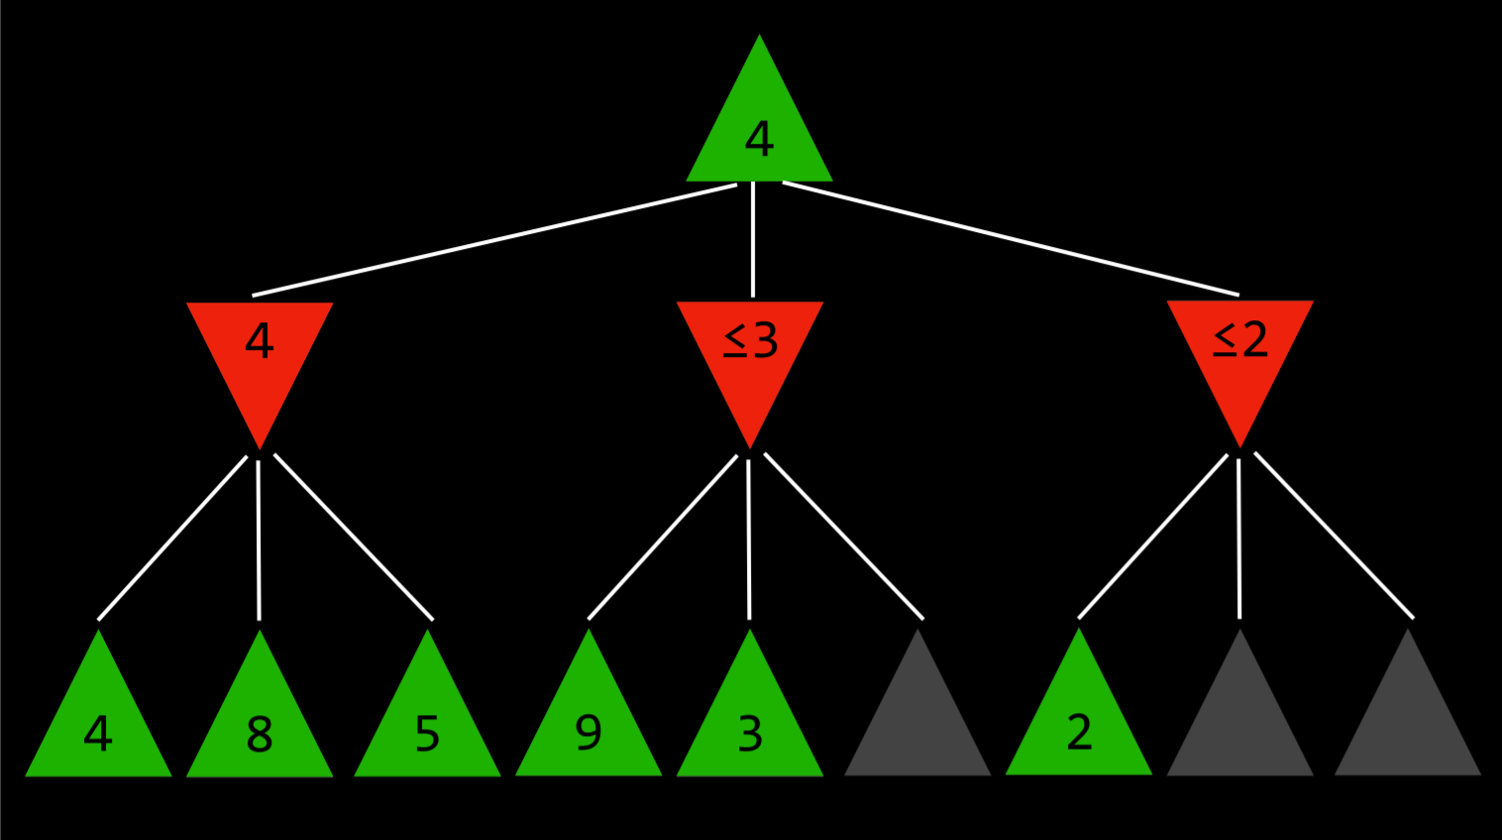
Prořezávání alfa–beta optimalizuje minimax tím, že vynechává některé rekurzivní výpočty, které jsou jednoznačně nevýhodné. Po stanovení hodnoty jedné akce není třeba dále zkoumat následující akci, pokud už víme, že soupeři umožní dosáhnout výhodnějšího skóre, než jaké poskytuje dříve vyhodnocená akce. Tato možnost je totiž pro nás určitě méně výhodná.
Nejlépe to ukazuje příklad. Maximalizující hráč ví, že minimalizující soupeř se v dalším kroku bude snažit dosáhnout nejnižšího skóre. Předpokládejme, že maximalizující hráč má tři možné akce a první získala hodnotu 4. Začne počítat hodnotu další akce: zkoumá hodnoty soupeřových akcí po svém tahu a ví, že soupeř vybere nejnižší z nich. Ještě než propočítá všechny možnosti, zjistí, že jedna má hodnotu 3. Nemá tedy důvod pokračovat ve zkoumání dalších akcí minimalizujícího hráče. Hodnota dosud nevyhodnocené akce už není podstatná, ať je 10, nebo (-10). Je-li 10, soupeř zvolí nižší hodnotu 3, která je pro maximalizujícího hráče horší než již známá 4. Je-li (-10), soupeř zvolí (-10), což je ještě méně výhodné. Další výpočty jsou proto z pohledu maximalizujícího hráče zbytečné: už má jednoznačně lepší možnost s hodnotou 4.
Minimax s omezenou hloubkou
Existuje celkem 255 168 možných her piškvorek a 10²⁹⁰⁰⁰ možných šachových her. Dosud popsaný minimax vyžaduje vytvořit všechny hypotetické hry od určitého stavu až do konce. U piškvorek to pro moderní počítač není obtížné, u šachu je to však v současnosti nemožné.
Minimax s omezenou hloubkou zvažuje pouze předem stanovený počet tahů a poté se zastaví, aniž by nutně dosáhl konečného stavu. Nemůže tedy přesně určit hodnotu každé akce, protože hypotetické hry nedoběhly do konce. Používá proto hodnoticí funkci, která odhaduje očekávaný užitek hry v daném stavu, tedy přiděluje stavům hodnoty. U šachu by například taková funkce dostala současné rozmístění figurek, pokusila se odhadnout jeho užitek podle počtu a polohy figurek obou hráčů a vrátila kladnou nebo zápornou hodnotu vyjadřující výhodnost pozice pro jednu stranu proti druhé. Tyto hodnoty pomáhají rozhodnout o správné akci. Čím lepší hodnoticí funkce, tím lepší minimax, který na ní závisí.