Hodnocení webových stránek (PageRank)
Nejnovější verze Pythonu, kterou byste v tomto kurzu měli používat, je Python 3.12.
Napište AI, která hodnotí webové stránky podle důležitosti.
$ python pagerank.py corpus0
PageRank Results from Sampling (n = 10000)
  1.html: 0.2223
  2.html: 0.4303
  3.html: 0.2145
  4.html: 0.1329
PageRank Results from Iteration
  1.html: 0.2202
  2.html: 0.4289
  3.html: 0.2202
  4.html: 0.1307
Kdy úkol dokončit
Jak získat pomoc
Výchozí informace
Když vyhledávače jako Google zobrazují výsledky, umisťují „důležitější“ a kvalitnější stránky výše než méně důležité. Jak ale vyhledávač pozná, které stránky jsou důležitější než jiné?
Jednou heuristikou může být, že „důležitá“ stránka má mnoho odkazů z jiných stránek: lze rozumně předpokládat, že na kvalitní stránku bude odkazovat více webů než na méně kvalitní. Mohli bychom si tedy představit systém, v němž každá stránka získá hodnocení podle počtu příchozích odkazů a vyšší hodnocení bude znamenat vyšší důležitost.
Tato definice však není dokonalá: pokud chce někdo, aby jeho stránka vypadala důležitěji, může vytvořit mnoho dalších stránek, které na ni odkazují, a uměle tak zvýšit její hodnocení.
Proto spoluzakladatelé Googlu včetně Larryho Page, po němž je pojmenován, vytvořili algoritmus PageRank. V PageRanku je web důležitější, pokud na něj odkazují jiné důležité weby. Odkazy z méně důležitých webů mají menší váhu. Definice působí trochu kruhově, ale ukazuje se, že tato hodnocení lze vypočítat několika způsoby.
Model náhodného surfaře
PageRank si lze představit pomocí modelu náhodného surfaře, který popisuje chování hypotetického člověka prohlížejícího internet a náhodně klikajícího na odkazy. Uvažujte korpus webových stránek níže, kde šipka mezi dvěma stránkami označuje odkaz z jedné na druhou.
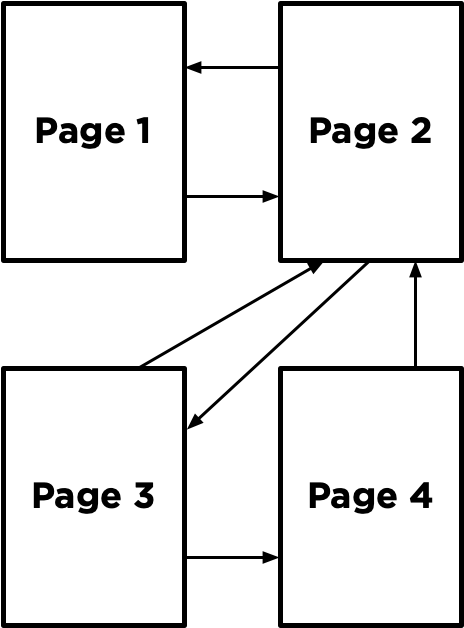
Model si představuje surfaře, který začne na náhodné webové stránce a pak náhodně vybírá odkazy, které bude následovat. Pokud je například na stránce 2, náhodně si vybere, zda navštíví stránku 1, nebo 3. Duplicitní odkazy na jedné stránce se počítají jako jeden a odkazy stránky na sebe samu se ignorují. Pokud si vybere stránku 3, potom náhodně zvolí mezi stránkami 2 a 4.
PageRank stránky pak lze popsat jako pravděpodobnost, že se na ní náhodný surfař nachází v libovolném okamžiku. Čím více odkazů vede na určitou stránku, tím je pravděpodobnější, že na ní skončí. Odkaz z důležitějšího webu se navíc proklikne pravděpodobněji než odkaz z méně důležitého webu, na který odkazuje méně stránek. Model tedy zohledňuje také váhu odkazů podle důležitosti.
Model můžeme interpretovat jako Markovův řetězec: každá stránka představuje stav a má přechodový model, který náhodně vybírá mezi jejími odkazy. V každém časovém kroku se stav změní na jednu ze stránek, na které současný stav odkazuje.
Náhodným vzorkováním stavů Markovova řetězce získáme odhad PageRanku jednotlivých stránek. Můžeme začít náhodným výběrem stránky, dále náhodně následovat odkazy a zaznamenávat počet návštěv každé stránky. Po shromáždění všech vzorků v předem zvoleném počtu může podíl času stráveného na jednotlivých stránkách sloužit jako odhad jejich hodnocení.
Tato definice PageRanku je však trochu problematická, pokud uvažujeme síť stránek jako níže.
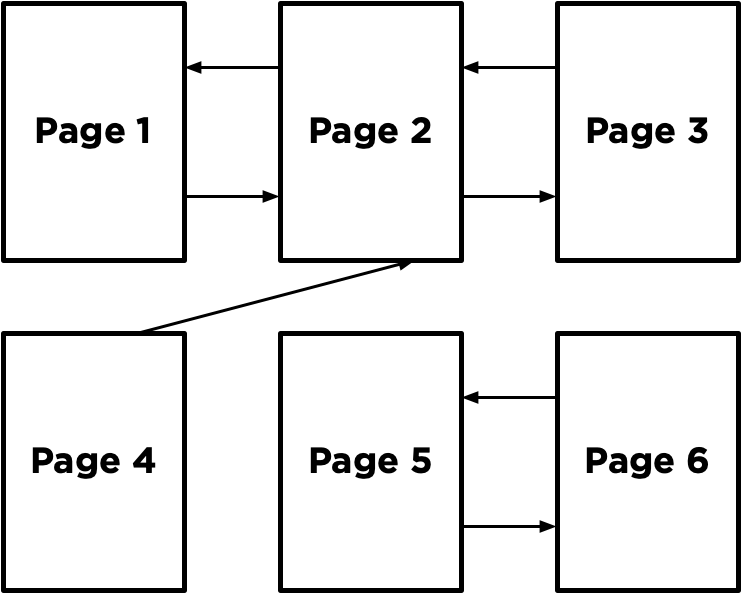
Představme si, že náhodně začneme výběrem stránky 5. Pak nemáme jinou možnost než přejít na stránku 6, následně zpět na 5, znovu na 6 a tak dále. Získali bychom odhad PageRanku 0,5 pro stránky 5 a 6 a 0 pro všechny ostatní, protože bychom všechen čas strávili jen na stránkách 5 a 6 a žádnou jinou nikdy nenavštívili.
Abychom se vždy mohli dostat i jinam v korpusu webových stránek, zavedeme do modelu tlumicí faktor d. S pravděpodobností d, kde d obvykle nastavujeme přibližně na 0.85, surfař náhodně vybere jeden z odkazů na současné stránce. Jinak, tedy s pravděpodobností 1 - d, náhodně vybere jednu ze všech stránek korpusu včetně té, na které právě je.
Náš náhodný surfař nyní začne náhodným výběrem stránky a pro každý další vzorek, který chceme vytvořit, s pravděpodobností d náhodně vybere odkaz ze současné stránky a s pravděpodobností 1 - d náhodně vybere libovolnou stránku. Pokud sledujeme, kolikrát se každá stránka objevila jako vzorek, můžeme podíl stavů na dané stránce považovat za její PageRank.
Iterativní algoritmus
PageRank stránky lze definovat také rekurzivním matematickým výrazem. Nechť PR(p) je PageRank stránky p: pravděpodobnost, že na ní náhodný surfař skončí. Jak PR(p) definovat? Víme, že surfař může na stránce skončit dvěma způsoby:
- S pravděpodobností
1 - dvybral náhodnou stránku a skončil nap. - S pravděpodobností
dnásledoval odkaz ze stránkyina stránkup.
První podmínku lze matematicky vyjádřit jednoduše: 1 - d děleno N, kde N je celkový počet stránek v korpusu. Pravděpodobnost 1 - d náhodného výběru stránky se totiž rovnoměrně rozdělí mezi všech N možných stránek.
U druhé podmínky musíme zvážit každou možnou stránku i, která odkazuje na p. Pro každou takovou příchozí stránku označme NumLinks(i) počet odkazů na stránce i. Každá stránka i odkazující na p má vlastní PageRank PR(i), tedy pravděpodobnost, že se v libovolném okamžiku nacházíme na i. Protože ze stránky i přecházíme na libovolný její odkaz se stejnou pravděpodobností, vydělíme PR(i) počtem odkazů NumLinks(i) a získáme pravděpodobnost, že jsme byli na i a vybrali odkaz na p.
Tím získáme následující definici PageRanku stránky p.
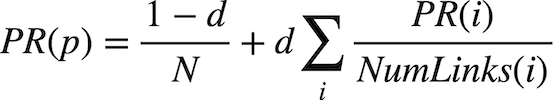
V tomto vzorci je d tlumicí faktor, N celkový počet stránek v korpusu, i prochází všechny stránky odkazující na p a NumLinks(i) je počet odkazů na stránce i.
Jak tedy hodnoty PageRanku vypočítáme? Pomocí iterací: nejprve předpokládáme PageRank 1 / N pro každou stránku, tedy stejnou pravděpodobnost výskytu na kterékoli stránce. Poté výše uvedeným vzorcem spočítáme nové hodnoty pro každou stránku na základě předchozích hodnot. Pokud proces opakujeme a vždy vypočítáme novou sadu z předchozí sady, hodnoty nakonec konvergují: při každé iteraci se již nezmění o více než malou prahovou hodnotu.
V projektu implementujete oba přístupy: výpočet PageRanku vzorkováním stránek náhodného surfaře v Markovově řetězci i opakovaným použitím vzorce PageRanku.
Začínáme
- Stáhněte výchozí kód z https://cdn.cs50.net/ai/2023/x/projects/2/pagerank.zip a rozbalte jej.
Porozumění výchozímu kódu
Otevřete pagerank.py. Nejprve si všimněte dvou konstant nahoře: DAMPING představuje tlumicí faktor, zpočátku nastavený na 0.85. SAMPLES představuje počet vzorků pro odhad PageRanku vzorkovací metodou, zpočátku nastavený na 10 000.
Nyní si prohlédněte funkci main. Očekává argument příkazového řádku: název adresáře s korpusem webových stránek, pro které chceme PageRank vypočítat. Funkce crawl přijme tento adresář, zpracuje všechny jeho soubory HTML a vrátí slovník reprezentující korpus. Klíče představují stránky, například "2.html", a hodnoty jsou množiny všech stránek, na které daný klíč odkazuje, například {"1.html", "3.html"}.
Funkce main poté zavolá sample_pagerank, jejímž účelem je odhadnout PageRank každé stránky pomocí vzorkování. Přijímá korpus stránek vytvořený funkcí crawl, tlumicí faktor a počet vzorků. Nakonec má sample_pagerank vrátit slovník, kde klíči jsou názvy stránek a hodnotami jejich odhadnuté PageRanky, čísla mezi 0 a 1.
Funkce main volá také iterate_pagerank, která vypočítá PageRank každé stránky iterativní metodou vzorce místo vzorkování. Návratová hodnota má mít stejný formát a při stejném korpusu by výsledky obou funkcí měly být podobné!
Specifikace
Mnoho studentů mělo v tomto úkolu potíže s automatickým hodnocením kvůli nesprávné konstrukci slovníků. Je nezbytné pečlivě číst specifikaci a přesně implementovat její požadavky.
Dokončete implementace transition_model, sample_pagerank a iterate_pagerank.
transition_model má vrátit slovník pravděpodobnostního rozdělení následující navštívené stránky náhodného surfaře při daném korpusu stránek, současné stránce a tlumicím faktoru.
- Funkce přijímá tři argumenty:
corpus,pageadamping_factor.corpusje slovník Pythonu mapující název stránky na množinu všech stránek, na které odkazuje.pageje řetězec označující stránku, na níž náhodný surfař právě je.damping_factorje desetinné číslo představující tlumicí faktor použitý k vytvoření pravděpodobností.
- Návratovou hodnotou má být slovník Pythonu s jedním klíčem pro každou stránku korpusu. Každý klíč má být mapován na pravděpodobnost, že surfař danou stránku vybere jako další. Součet hodnot vráceného pravděpodobnostního rozdělení má být
1.- S pravděpodobností
damping_factormá surfař náhodně a se stejnou pravděpodobností zvolit jeden z odkazů zpage. - S pravděpodobností
1 - damping_factormá surfař náhodně a se stejnou pravděpodobností zvolit jednu ze všech stránek v korpusu.
- S pravděpodobností
- Pokud by například
corpusbyl{"1.html": {"2.html", "3.html"}, "2.html": {"3.html"}, "3.html": {"2.html"}},pagebyla"1.html"adamping_factorbyl0.85, měl by výstuptransition_modelbýt{"1.html": 0.05, "2.html": 0.475, "3.html": 0.475}. S pravděpodobností0.85totiž náhodně zvolíme přechod ze stránky 1 na stránku 2 či 3, takže obě mají zpočátku pravděpodobnost0.425. Každá stránka však navíc dostane0.05, protože s pravděpodobností0.15náhodně vybíráme mezi všemi třemi stránkami. - Pokud
pagenemá žádné odchozí odkazy, mátransition_modelvrátit rozdělení rovnoměrného náhodného výběru mezi všemi stránkami. Jinými slovy u stránky bez odkazů můžeme předstírat, že odkazuje na všechny stránky korpusu včetně sebe samé.
Funkce sample_pagerank má přijmout korpus webových stránek, tlumicí faktor a počet vzorků a vrátit odhadnutý PageRank každé stránky.
- Funkce přijímá tři argumenty:
corpus,damping_factoran.corpusje slovník Pythonu mapující název stránky na množinu všech stránek, na které odkazuje.damping_factorje desetinné číslo představující tlumicí faktor použitý přechodovým modelem.nje celé číslo udávající počet vzorků, které se mají vytvořit k odhadu hodnot PageRanku.
- Návratovou hodnotou má být slovník Pythonu s jedním klíčem pro každou stránku korpusu. Každý klíč má být mapován na její odhadnutý PageRank, tedy podíl všech vzorků odpovídajících dané stránce. Součet hodnot ve slovníku má být
1. - První vzorek má vzniknout náhodným výběrem stránky.
- Každý další vzorek má být vytvořen z předchozího vzorku podle jeho přechodového modelu.
- Pravděpodobně budete chtít předchozí vzorek předat funkci
transition_modelspolu scorpusadamping_factor, abyste získali pravděpodobnosti dalšího vzorku. - Pokud jsou například přechodové pravděpodobnosti
{"1.html": 0.05, "2.html": 0.475, "3.html": 0.475}, má být v 5 % případů dalším vzorkem"1.html", ve 47,5 % případů"2.html"a ve 47,5 % případů"3.html".
- Pravděpodobně budete chtít předchozí vzorek předat funkci
- Můžete předpokládat, že
nbude alespoň1.
Funkce iterate_pagerank má přijmout korpus webových stránek a tlumicí faktor, vypočítat PageRanky podle výše popsaného iterativního vzorce a vrátit PageRank každé stránky s přesností do 0.001.
- Funkce přijímá dva argumenty:
corpusadamping_factor.corpusje slovník Pythonu mapující název stránky na množinu všech stránek, na které odkazuje.damping_factorje desetinné číslo představující tlumicí faktor použitý ve vzorci PageRanku.
- Návratovou hodnotou má být slovník Pythonu s jedním klíčem pro každou stránku korpusu. Každý klíč má být mapován na její PageRank. Součet hodnot ve slovníku má být
1. - Funkce má začít přiřazením hodnocení
1 / Nkaždé stránce, kdeNje celkový počet stránek v korpusu. - Poté má opakovaně vypočítávat nové hodnoty podle všech současných hodnot a vzorce PageRanku ve výchozích informacích. PageRank stránky tedy počítá z PageRanků všech stránek, které na ni odkazují.
- Stránku bez jakýchkoli odkazů chápejte, jako by měla jeden odkaz na každou stránku v korpusu včetně sebe samé.
- Proces se má opakovat, dokud se mezi současnými a novými hodnotami žádný PageRank nezmění o více než
0.001.
V pagerank.py neměňte nic kromě tří funkcí určených k implementaci ve specifikaci. Můžete však napsat další funkce a případně importovat další moduly standardní knihovny Pythonu. Pokud je znáte, můžete importovat také numpy nebo pandas, ale žádné další moduly Pythonu od třetích stran používat nemáte.
Nápověda
- Pro pseudonáhodná rozhodnutí se vám mohou hodit funkce modulu
randomv Pythonu.
Testování
Pokud chcete, můžete po nastavení check50 ve svém systému spustit následující příkaz pro ověření správnosti kódu. Není to povinné; můžete úkol jednoduše odevzdat podle kroků na konci specifikace a stejné testy se spustí na našem serveru. V každém případě kód také sami zkompilujte a otestujte!
check50 ai50/projects/2024/x/pagerank
Následujícím příkazem zkontrolujte styl svého kódu pomocí style50.
style50 pagerank.py
Pamatujte, že kromě modulů standardní knihovny Pythonu nesmíte importovat žádné jiné moduly než ty, které jsou zde výslovně povoleny. Jinak se nejen nespustí check50, ale ani submit50 nebude moci úkol ohodnotit, protože používá check50. Pokud k tomu dojde, pravděpodobně jste importovali něco nepovoleného nebo výchozí kód jinak změnili způsobem, který zadání nepovoluje. Existují nástroje, které některé projekty značně zjednodušují, ale to zde není cílem: učíte se na nižší úrovni. Pokud zde není řečeno, že je můžete používat, používat je nesmíte.
Jak úkol odevzdat
- Navštivte tento odkaz, přihlaste se účtem GitHub a klikněte na Authorize cs50. Poté zaškrtněte políčko udělující týmu kurzu přístup k vašim odevzdaným pracím a klikněte na Join course.
- Nainstalujte Git a volitelně nainstalujte
submit50. - Pokud máte nainstalovaný
submit50, spusťtesubmit50 ai50/projects/2024/x/pagerankJinak pomocí Gitu odešlete práci do
https://github.com/me50/USERNAME.git, kdeUSERNAMEje vaše uživatelské jméno GitHub, do větve pojmenovanéai50/projects/2024/x/pagerank.
Pokud kód odevzdáváte přímo pomocí Gitu místo submit50, nezahrnujte jiné soubory ani složky než ty, které máte podle výše uvedené specifikace skutečně upravit. Jinými slovy nenahrávejte celý svůj adresář!
Práce by měla být ohodnocena do pěti minut. Pak můžete na https://cs50.me/cs50ai zobrazit aktuální postup!