Přednáška 4
Strojové učení
Strojové učení poskytuje počítači data místo výslovných pokynů. Pomocí těchto dat se počítač učí rozpoznávat vzory a získává schopnost sám vykonávat úkoly.
Učení s učitelem
Při učení s učitelem se počítač na základě datové sady dvojic vstup–výstup učí funkci, která mapuje vstupy na výstupy.
Učení s učitelem zahrnuje více typů úloh; jedním z nich je klasifikace. Funkce v ní mapuje vstup na diskrétní výstup. Například podle vlhkosti a tlaku vzduchu v určitém dni, tedy vstupu, počítač rozhodne, zda bude pršet, tedy určí výstup. Nejprve se přitom natrénuje na datech z více dnů, u nichž už víme, zda při dané vlhkosti a tlaku pršelo.
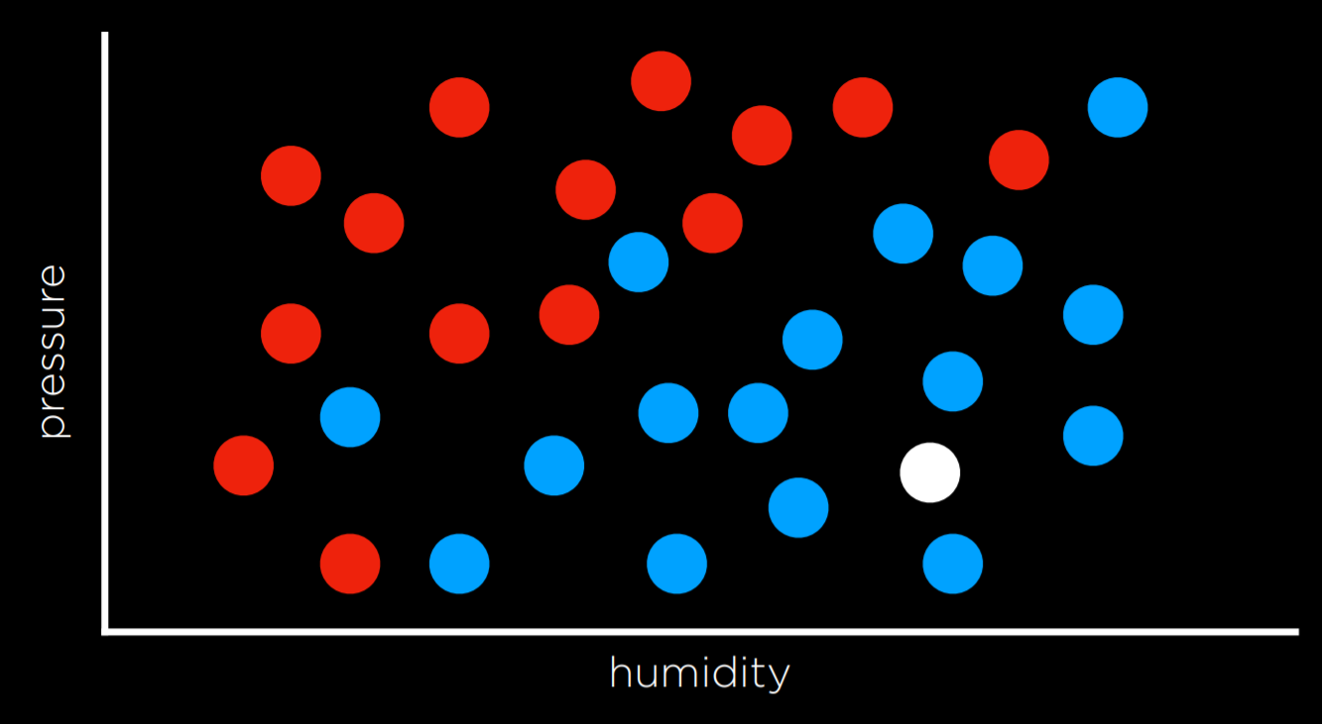
Úlohu můžeme formalizovat takto. V přírodě pozorujeme funkci f(humidity, pressure), která ze vstupu určuje jednu z diskrétních hodnot Rain nebo No Rain, tedy déšť či bez deště. Tuto funkci neznáme a patrně ji ovlivňuje mnoho dalších proměnných, k nimž nemáme přístup. Chceme vytvořit funkci h(humidity, pressure), která chování f přibližně napodobí. Úlohu lze znázornit zakreslením jednotlivých dnů podle vlhkosti a deště jako vstupu; body dnů s deštěm obarvíme modře a bez deště červeně, což představuje výstup. Bílý bod má pouze vstupní údaje a počítač musí určit výstup.
Klasifikace nejbližším sousedem
Jedním řešením je přiřadit zkoumané proměnné hodnotu nejbližšího pozorování. Bílý bod v grafu výše bychom tedy obarvili modře, protože nejbližší pozorovaný bod je modrý. Někdy to funguje dobře, ale podívejme se na následující graf.
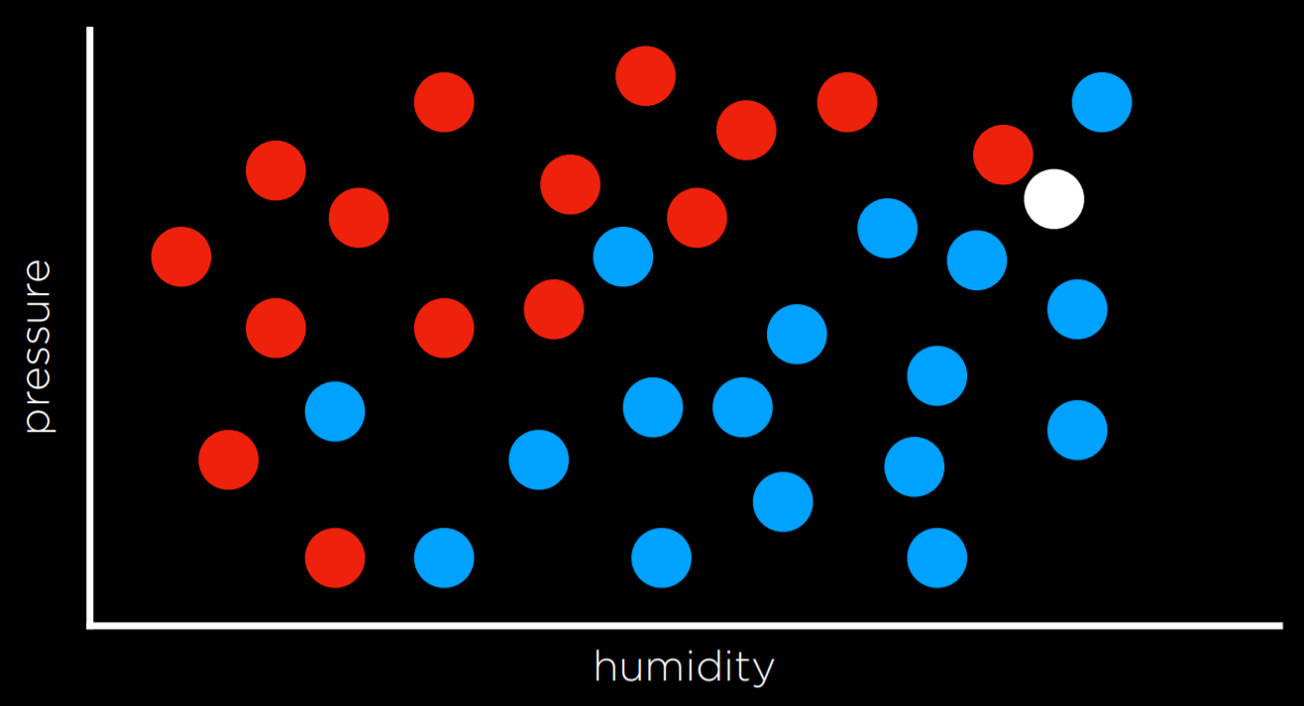
Stejným postupem bychom bílý bod obarvili červeně, protože nejbližší pozorování je červené. Při pohledu na širší okolí však vidíme převahu modrých bodů. Intuitivně tak může být modrá lepší predikcí, přestože nejbližší bod je červený.
Omezení tohoto postupu lze obejít pomocí klasifikace k nejbližšími sousedy: bod obarvíme nejčastější barvou jeho k nejbližších sousedů. Hodnotu k volí programátor. Při klasifikaci třemi nejbližšími sousedy by například bílý bod výše byl modrý, což intuitivně působí jako lepší rozhodnutí.
Nevýhodou je, že naivní algoritmus musí změřit vzdálenost zkoumaného bodu ke každému dalšímu bodu, což je výpočetně náročné. Urychlení umožňují datové struktury pro rychlejší vyhledávání sousedů nebo vyřazování nerelevantních pozorování.
Učení perceptronu
Další přístup ke klasifikaci místo hledání sousedů posuzuje data jako celek a hledá rozhodovací hranici. U dvourozměrných dat můžeme mezi dva typy pozorování nakreslit přímku. Každý nový bod potom klasifikujeme podle toho, na které straně přímky leží.
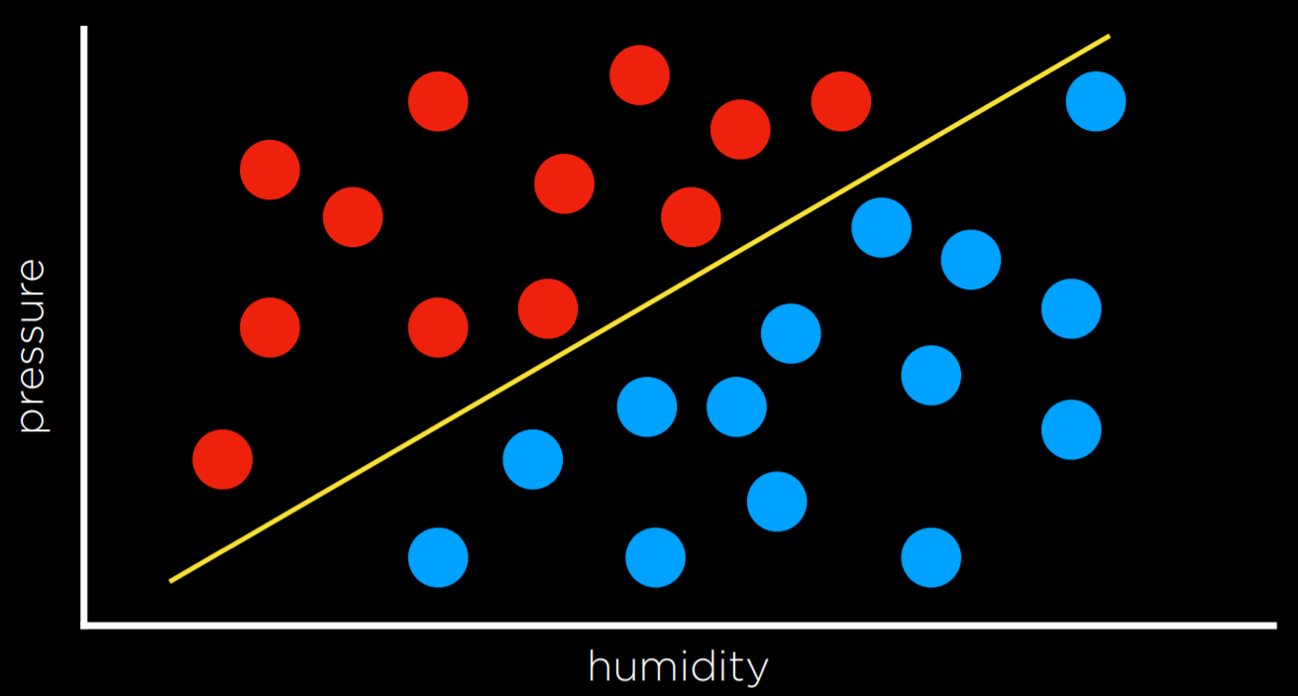
Nevýhodou je, že data jsou neuspořádaná a jen zřídka je lze přímkou bezchybně rozdělit do dvou tříd. Často tedy přijmeme kompromis: hranice bude většinu pozorování oddělovat správně, ale někdy je klasifikuje chybně.
V tomto případě vstupy
- x₁ = vlhkost
- x₂ = tlak
předáme hypotetické funkci h(x₁, x₂), která předpoví, zda bude v daném dni pršet. Zkontroluje, na které straně rozhodovací hranice pozorování leží. Formálně každému vstupu přiřadí váhu a přidá konstantu, čímž vznikne lineární výraz následujícího tvaru:
- Déšť, pokud w₀ + w₁x₁ + w₂x₂ ≥ 0
- Jinak bez deště
Výstupní proměnnou často kódujeme čísly 1 a 0: je-li hodnota výrazu větší než 0, výstup je 1, déšť; jinak 0, bez deště.
Váhy a hodnoty představujeme vektory, tedy posloupnostmi čísel, které lze v Pythonu uložit jako seznamy či tuple. Vytvoříme vektor vah w: (w₀, w₁, w₂). Cílem algoritmu strojového učení je najít nejlepší vektor vah. Vytvoříme také vstupní vektor x: (1, x₁, x₂).
Vypočteme skalární součin obou vektorů: každou hodnotu prvního násobíme odpovídající hodnotou druhého a výsledky sečteme. Dostaneme výraz w₀ + w₁x₁ + w₂x₂. První hodnota vstupního vektoru je 1, aby při násobení váhou w₀ zůstala tato váha konstantou.
Hypotetickou funkci tedy můžeme vyjádřit takto:
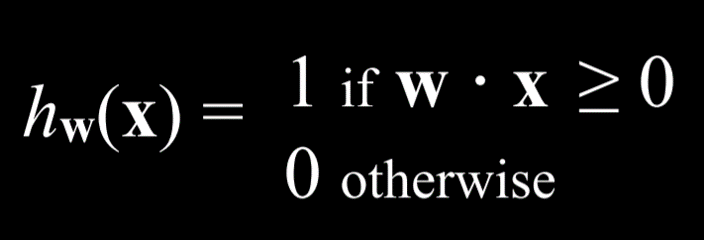
Protože algoritmus hledá nejlepší vektor vah, při setkání s novými daty aktuální váhy upraví. Používá k tomu pravidlo učení perceptronu:
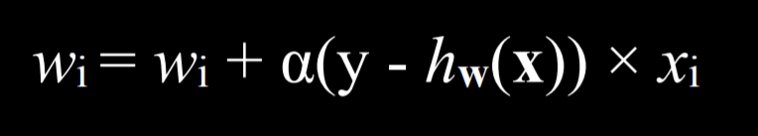
Hlavní myšlenka pravidla je, že pro každý datový bod upravíme váhy tak, aby byla funkce přesnější. Podrobněji: každá váha se nastaví na svou původní hodnotu plus výraz v závorce. y označuje pozorovanou hodnotu, zatímco hypotetická funkce odhad. Jsou-li stejné, celý tento výraz je nula a váha se nezmění. Pokud jsme hodnotu podhodnotili, tedy předpověděli bez deště, ale pršelo, výraz v závorce je 1 a váha vzroste o xᵢ násobené učicím koeficientem α. Pokud jsme hodnotu nadhodnotili, tedy předpověděli déšť, ale nepršelo, výraz je −1 a váha klesne o x násobené α. Čím vyšší α, tím silněji každé nové pozorování váhu ovlivní.
Výsledkem je prahová funkce, která po překročení určitého prahu odhadované hodnoty přepne z 0 na 1.
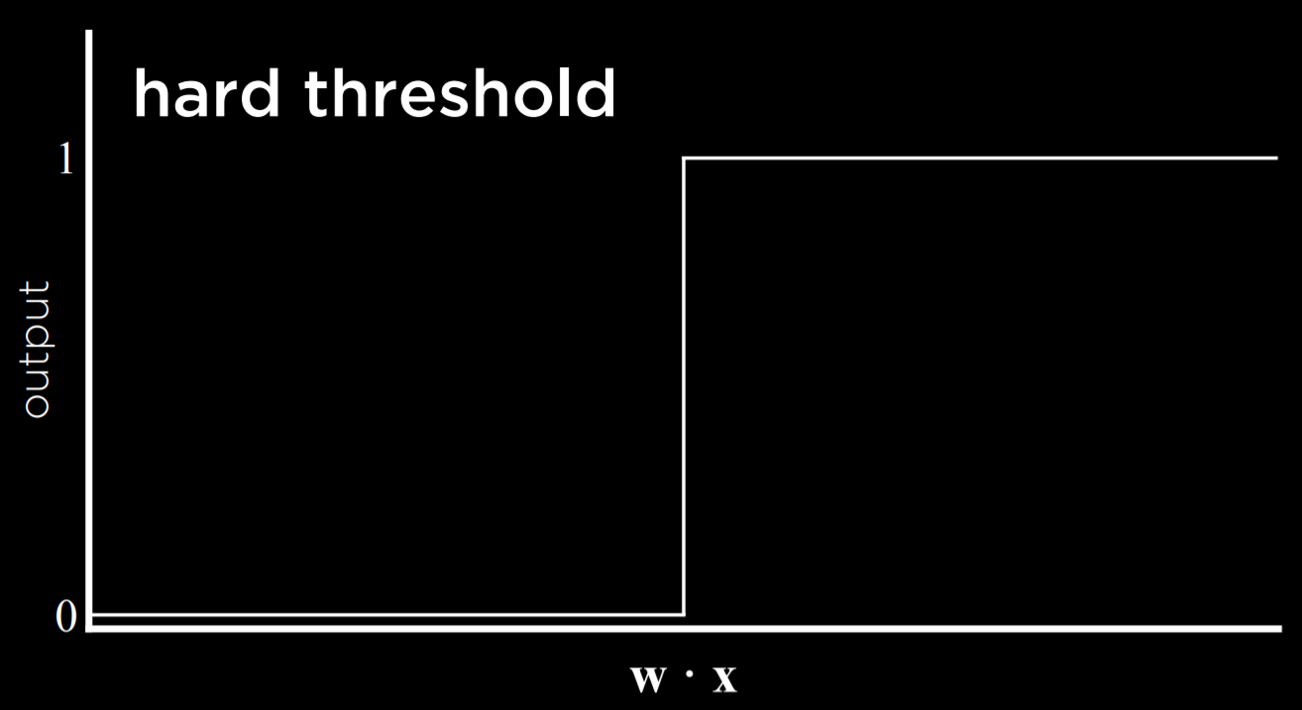
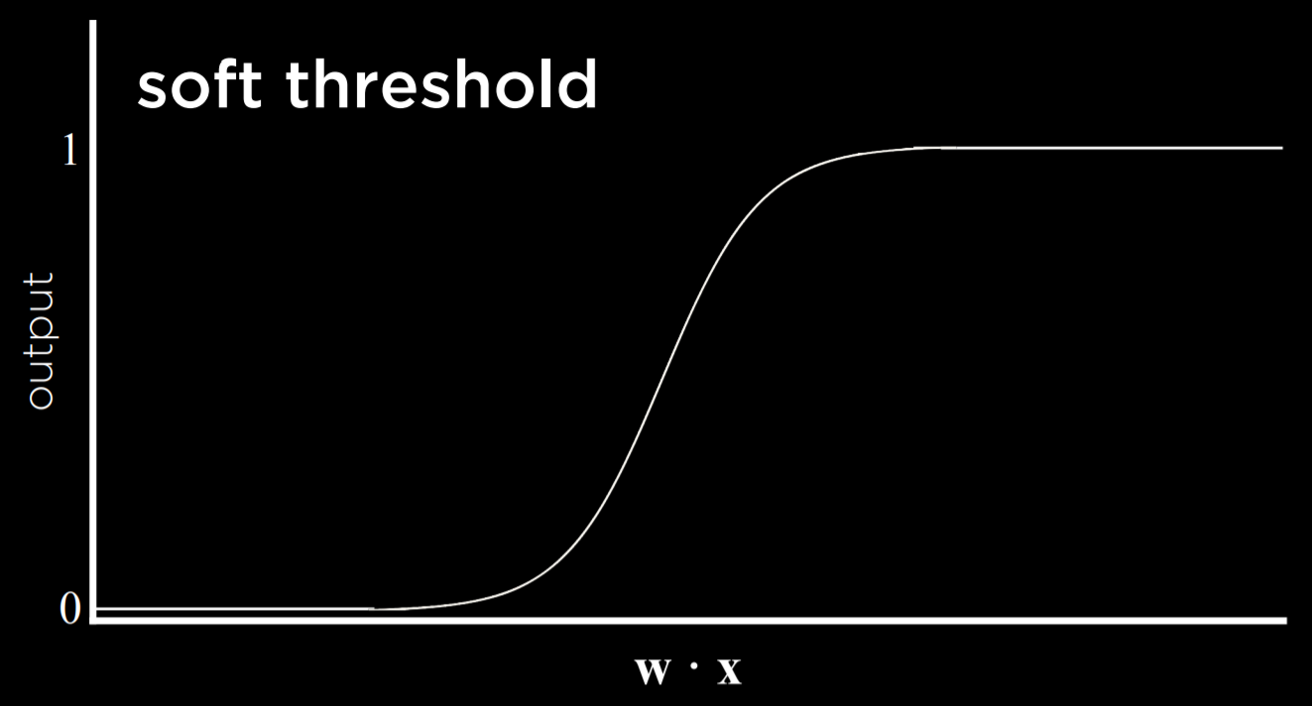
Taková funkce neumí vyjádřit nejistotu, protože vrací pouze 0 nebo 1. Používá tvrdý práh. Můžeme jej nahradit logistickou funkcí s měkkým prahem. Ta vrací reálné číslo mezi 0 a 1, které vyjadřuje míru jistoty odhadu. Čím blíže jedné, tím pravděpodobnější je déšť.
Metoda podpůrných vektorů
Vedle nejbližších sousedů a lineární regrese je dalším přístupem ke klasifikaci metoda podpůrných vektorů, Support Vector Machine. V blízkosti rozhodovací hranice používá další vektor, podpůrný vektor, který pomáhá optimálně oddělit data. Podívejme se na příklad:
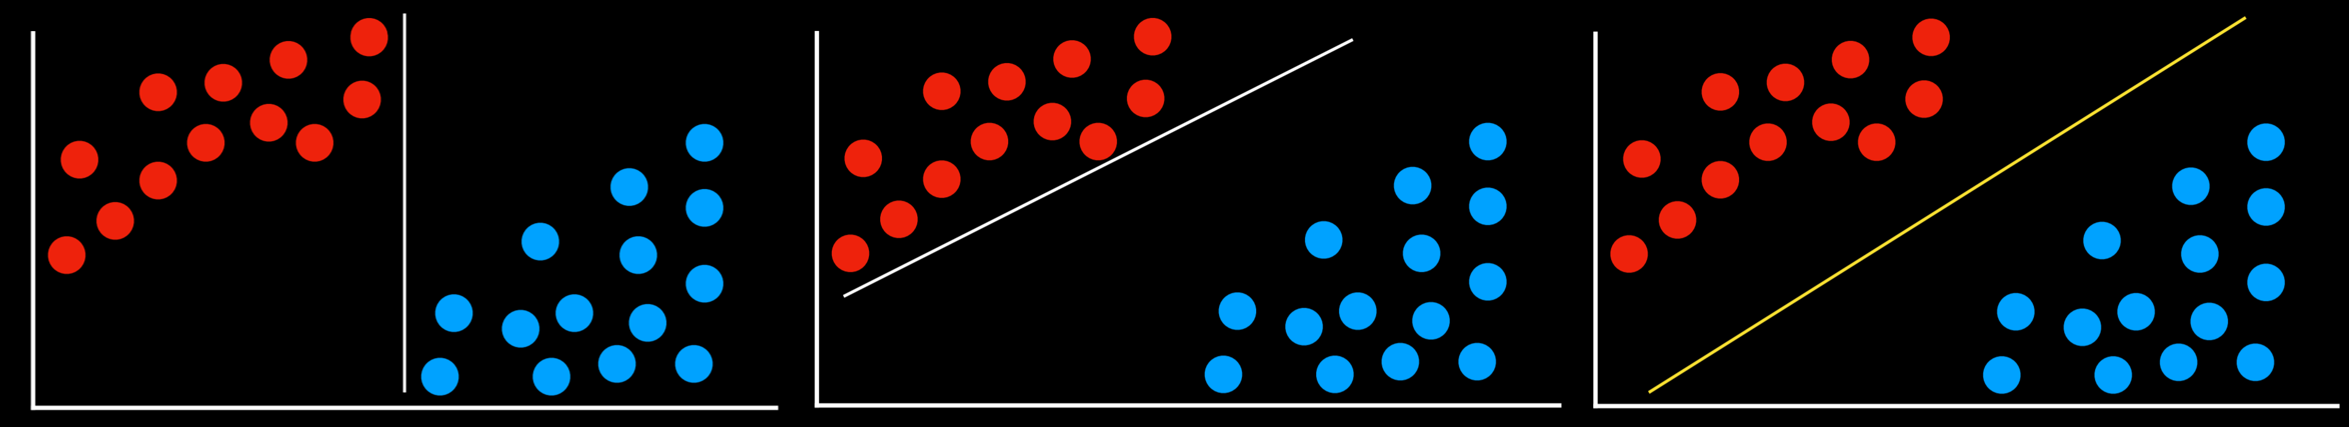
Všechny zobrazené rozhodovací hranice oddělují data bez chyb. Jsou ale stejně dobré? Dvě vlevo leží velmi blízko některých pozorování. Nový bod, který se od své skupiny liší jen málo, tak může být chybně přiřazen druhé skupině. Hranice vpravo udržuje největší odstup od obou skupin a ponechává největší prostor pro proměnlivost. Takové hranici, která je co nejdále od obou oddělovaných skupin, říkáme oddělující hranice s maximální rezervou.
Další výhodou podpůrných vektorů je možnost vyjádřit hranice ve více než dvou rozměrech a také nelineární rozhodovací hranice, jako níže.
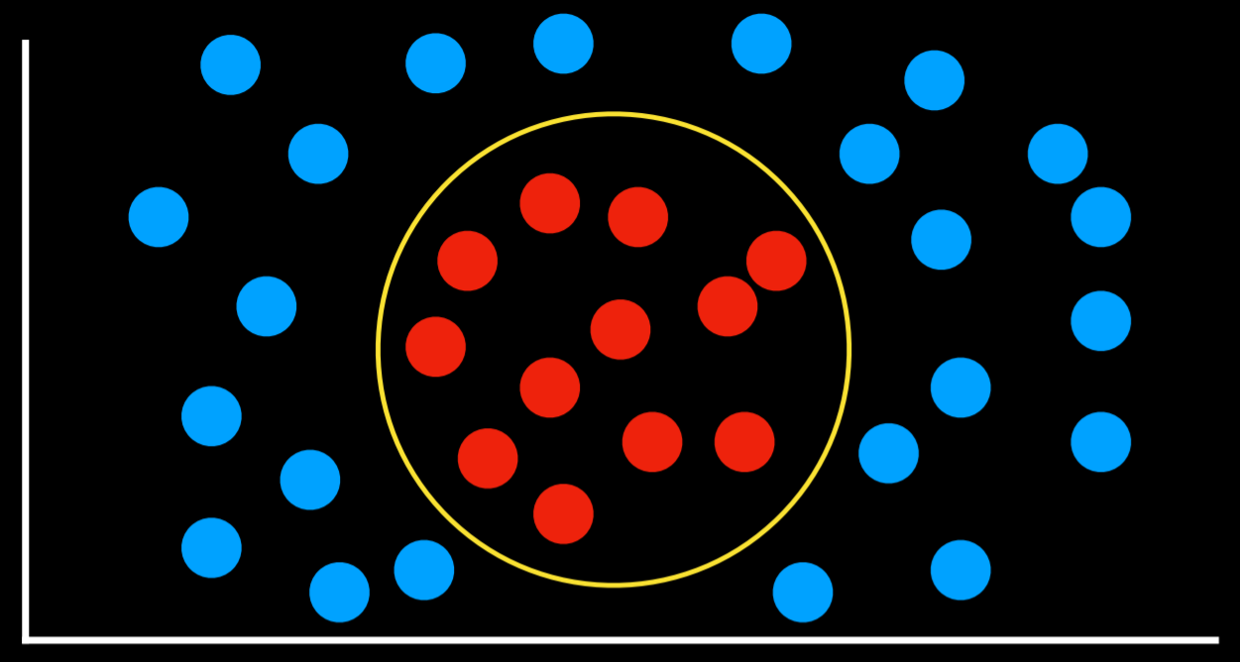
Klasifikační úlohy tedy lze řešit více způsoby a žádný není vždy lepší než ostatní. Každý má nevýhody a v konkrétní situaci může být užitečnější než jiný.
Regrese
Regrese je úloha učení s učitelem, v níž funkce mapuje vstupní bod na spojitou hodnotu, tedy určité reálné číslo. Liší se tak od klasifikace, která mapuje vstup na diskrétní hodnoty, například déšť či bez deště.
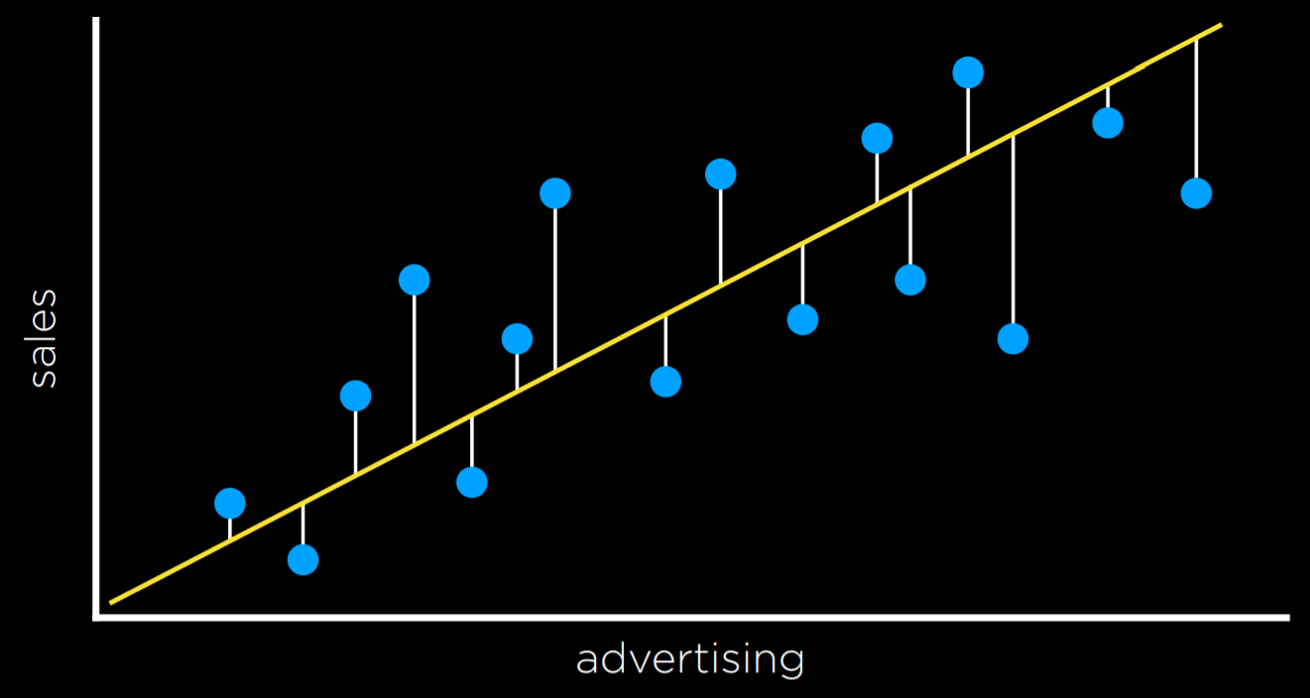
Firma může například pomocí regrese zkoumat, jak peníze vydané za reklamu předpovídají tržby. Pozorovaná funkce f(advertising) vyjadřuje příjem po určité reklamní útratě; může přitom mít i více vstupních proměnných. Z těchto dat vycházíme. Chceme najít hypotetickou funkci h(advertising), která přibližně napodobí chování f. h určí přímku, jejímž cílem není oddělit druhy pozorování, ale ze vstupu předpovědět výstupní hodnotu.

Ztrátové funkce
Ztrátové funkce kvantifikují užitek ztracený při použití některého rozhodovacího pravidla výše. Čím méně přesná predikce, tím větší ztráta.
Pro klasifikaci lze použít ztrátovou funkci 0–1.
- L(actual, predicted):
- 0, pokud actual = predicted
- 1 v ostatních případech
Tato funkce tedy nabývá kladné hodnoty při chybné predikci a nuly při správné, když se pozorovaná a předpovězená hodnota shodují.
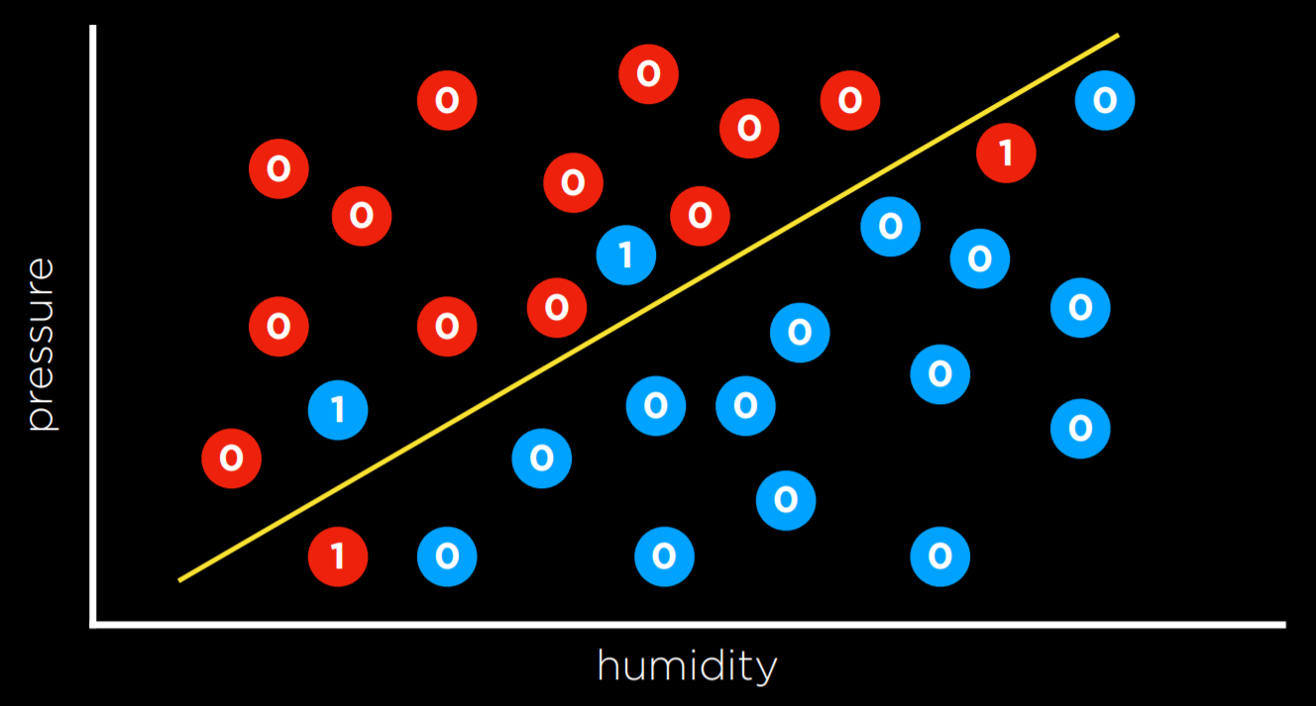
V příkladu výše mají hodnotu 0 dny, u nichž jsme počasí předpověděli správně: deštivé pod přímkou a nedeštivé nad ní. Nedeštivé dny pod přímkou a deštivé nad ní jsou chyby. Každé dáme hodnotu 1 a sečtením získáme empirický odhad ztráty rozhodovací hranice.
Při předpovídání spojité hodnoty lze použít ztrátové funkce L₁ a L₂. Zajímá nás, o kolik se každá predikce liší od pozorované hodnoty. Použijeme absolutní hodnotu nebo druhou mocninu rozdílu pozorované a předpovězené hodnoty, tedy vzdálenosti predikce od skutečnosti.
- L₁: L(actual, predicted) = |actual - predicted|
- L₂: L(actual, predicted) = (actual - predicted)²
Můžeme zvolit funkci nejvhodnější pro náš cíl. L₂ trestá odlehlé hodnoty silněji než L₁, protože rozdíl umocňuje. L₁ lze znázornit součtem vzdáleností každého pozorovaného bodu k odpovídajícímu predikovanému bodu na regresní přímce:
Přeučení
Přeučení nastává, když model natolik dobře odpovídá trénovacím datům, že nedokáže zobecnit na jiné datové sady. Ztrátové funkce jsou tak dvojsečné. V obou příkladech níže jsme ztrátu minimalizovali až na 0, ale model pravděpodobně nebude dobře odpovídat novým datům.
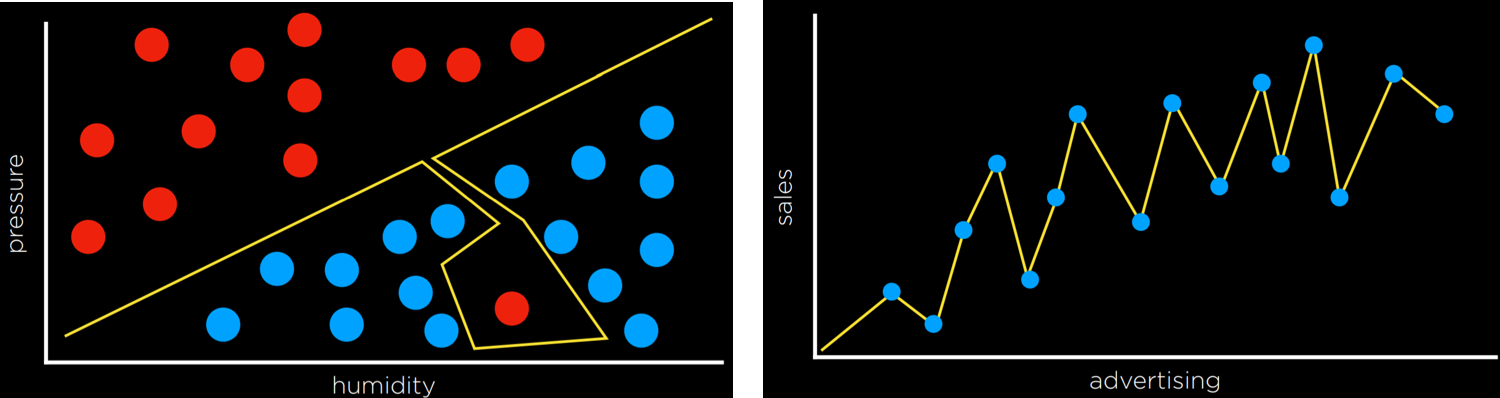
Například bod poblíž spodního červeného bodu v levém grafu patrně představuje déšť, modrou barvu. Přeučený model jej však klasifikuje jako bez deště, červeně.
Regularizace
Regularizace penalizuje složitější hypotézy a upřednostňuje jednodušší, obecnější. Používáme ji proti přeučení.
Při regularizaci odhadujeme náklad hypotetické funkce h jako součet její ztráty a míry složitosti.
cost(h) = loss(h) + λcomplexity(h)
Lambda (λ) je konstanta, kterou nastavujeme sílu penalizace složitosti v nákladové funkci. Čím vyšší λ, tím dražší je složitost.
Přeučení lze zkoumat pomocí validace s vyčleněnou sadou, holdout cross validation. Data rozdělíme na trénovací sadu a testovací sadu. Algoritmus spustíme na trénovacích datech a pak ověříme, jak dobře předpovídá testovací data. Testováním na datech nepoužitých při trénování změříme schopnost učení zobecňovat.
Nevýhodou je, že na polovině dat model netrénujeme, protože slouží k vyhodnocení. Řešením může být křížová validace s k částmi, k-fold cross-validation. Data rozdělíme do k sad a trénování provedeme k-krát. Pokaždé vynecháme jinou sadu, která poslouží k testu. Získáme k vyhodnocení modelu, jejichž průměrem odhadneme jeho zobecňování bez ztráty dat.
scikit-learn
Jak bývá v Pythonu běžné, existuje více knihoven umožňujících pohodlně využívat algoritmy strojového učení. Jednou z nich je scikit-learn.
Jako příklad použijeme datovou sadu padělaných bankovek ve formátu CSV.
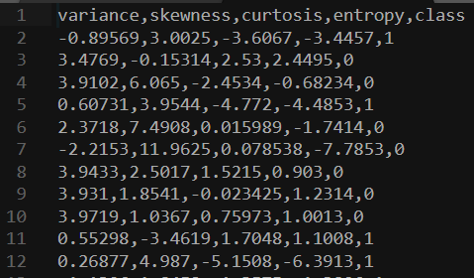
Čtyři levé sloupce obsahují údaje, z nichž lze předpovědět pravost bankovky. Člověk poskytl další údaj, zda je pravá či padělaná, zakódovaný jako 0 a 1. Na této sadě můžeme model natrénovat a ověřit, zda rozpozná pravost nových bankovek.
import csv
import random

from sklearn import svm
from sklearn.linear_model import Perceptron
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier

# model = KNeighborsClassifier(n_neighbors=1)
# model = svm.SVC()
model = Perceptron()
Po importu knihoven můžeme vybrat model; zbytek kódu zůstane stejný. SVC znamená Support Vector Classifier, klasifikátor využívající metodu podpůrných vektorů. KNeighborsClassifier používá strategii k sousedů a jako vstup vyžaduje jejich počet.
# Read data in from file
with open("banknotes.csv") as f:
    reader = csv.reader(f)
    next(reader)

    data = []
    for row in reader:
        data.append({
            "evidence": [float(cell) for cell in row[:4]],
            "label": "Authentic" if row[4] == "0" else "Counterfeit"
        })

# Separate data into training and testing groups
holdout = int(0.40 * len(data))
random.shuffle(data)
testing = data[:holdout]
training = data[holdout:]

# Train model on training set
X_training = [row["evidence"] for row in training]
y_training = [row["label"] for row in training]
model.fit(X_training, y_training)

# Make predictions on the testing set
X_testing = [row["evidence"] for row in testing]
y_testing = [row["label"] for row in testing]
predictions = model.predict(X_testing)

# Compute how well we performed
correct = 0
incorrect = 0
total = 0
for actual, predicted in zip(y_testing, predictions):
    total += 1
    if actual == predicted:
        correct += 1
    else:
        incorrect += 1

# Print results
print(f"Results for model {type(model).__name__}")
print(f"Correct: {correct}")
print(f"Incorrect: {incorrect}")
print(f"Accuracy: {100 * correct / total:.2f}%")
Tuto ručně napsanou variantu algoritmu najdeš ve zdrojovém kódu přednášky v banknotes0.py. Protože se algoritmus často používá stejným způsobem, scikit-learn obsahuje další funkce, které kód zkracují a usnadňují; tato varianta je v banknotes1.py.
Posilované učení
Posilované učení je další přístup ke strojovému učení. Po každé akci agent obdrží zpětnou vazbu v podobě odměny nebo trestu, tedy kladné či záporné číselné hodnoty.
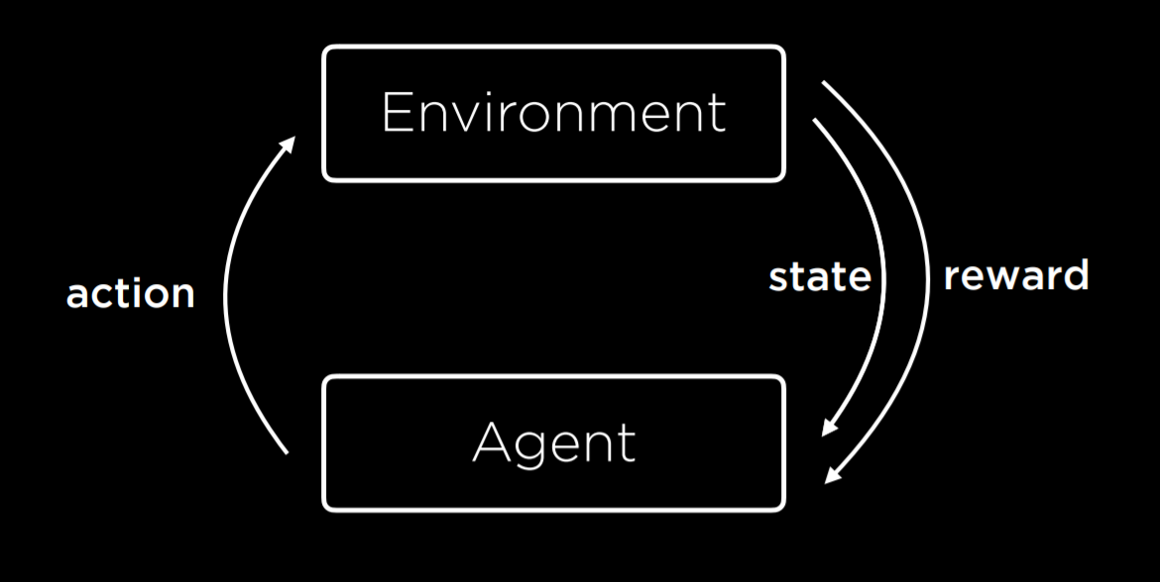
Proces začíná tím, že prostředí poskytne agentovi stav. Agent v něm provede akci. Prostředí podle této akce vrátí nový stav a odměnu. Kladná odměna zvyšuje pravděpodobnost budoucího výskytu tohoto chování; záporná odměna, tedy trest, ji snižuje.
Takový algoritmus lze například použít při učení robotů chůzi: každý krok přinese kladné číslo, odměnu, a každý pád záporné, trest.
Markovovy rozhodovací procesy
Posilované učení lze chápat jako Markovův rozhodovací proces s těmito vlastnostmi:
- Množina stavů S.
- Množina akcí Actions(S).
- Přechodový model P(s’ | s, a).
- Funkce odměny R(s, a, s’).
Uvažujme například tuto úlohu:
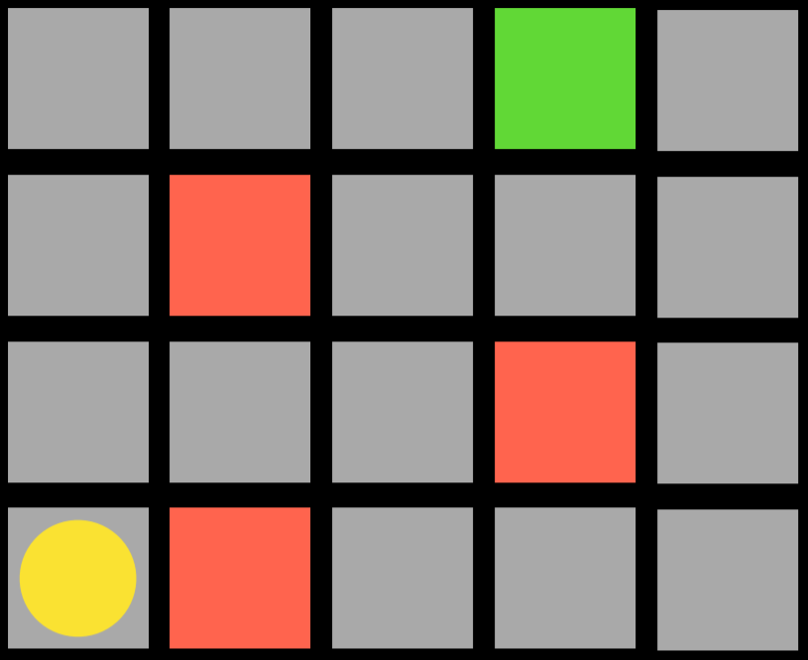
Agent je žlutý kruh. Musí dojít k zelenému políčku a vyhnout se červeným. Každé políčko je stav a pohyb nahoru, dolů či do stran je akce. Přechodový model určí nový stav po akci, funkce odměny druh zpětné vazby. Zvolí-li agent například pohyb doprava, stoupne na červené políčko a dostane zápornou zpětnou vazbu. Naučí se tak, že z levého dolního políčka se nemá pohybovat doprava. Prozkoumává prostor a učí se, kterým dvojicím stav–akce se vyhnout. Algoritmus může být pravděpodobnostní: různé akce volí s pravděpodobností, která podle odměny roste či klesá. Po dosažení zeleného políčka dostane kladnou odměnu a naučí se, že akce z předchozího stavu byla výhodná.
Q-learning
Q-learning je model posilovaného učení, v němž funkce Q(s, a) odhaduje hodnotu provedení akce a ve stavu s.
Model začíná s nulovými odhady: Q(s,a) = 0 pro všechny dvojice s, a. Po akci a odměně funkce provede dvě věci: 1) odhadne Q(s, a) podle aktuální a očekávaných budoucích odměn; 2) upraví Q(s, a) se zohledněním starého i nového odhadu. Algoritmus tak zlepšuje již získané znalosti, aniž by začínal znovu od nuly.
Q(s, a) ⟵ Q(s, a) + α(nový odhad hodnoty − Q(s, a))
Nová hodnota Q(s, a) se rovná původní hodnotě plus aktualizační člen. Ten je rozdílem nového a starého odhadu násobeným učicím koeficientem α. Při α = 1 nový odhad prostě přepíše starý. Při α = 0 se hodnota vůbec nemění. Úpravou α tedy určujeme, jak rychle nové odhady mění dosavadní znalosti.
Nový odhad lze vyjádřit součtem odměny r a odhadu budoucí odměny. Ten získáme posouzením nového stavu po poslední akci a přičtením odhadu akce, která v něm přinese nejvyšší odměnu. Užitečnost akce a ve stavu s tedy odhadujeme z její vlastní odměny i z očekávaného užitku dalšího kroku. U budoucí odměny se někdy objeví koeficient gama, který řídí její význam. Dostaneme následující rovnici:
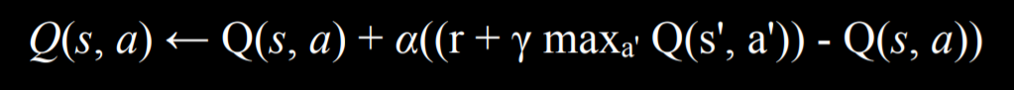
Hladové rozhodování zcela pomíjí odhadované budoucí odměny a vždy vybírá akci a v aktuálním stavu s s nejvyšší hodnotou Q(s, a).
Tím se dostáváme ke kompromisu mezi průzkumem a využíváním znalostí, Explore vs. Exploit. Hladový algoritmus vždy využívá známé možnosti: volí akce, u nichž už ví, že vedou k dobrým výsledkům. Sleduje tak ale stále stejnou cestu k řešení a lepší nenajde. Průzkum naopak dovoluje zkoušet neprozkoumané trasy a objevovat efektivnější řešení. Pokud například pokaždé posloucháš stejné písničky, víš, že se ti budou líbit, ale nikdy nepoznáš nové, které by se ti mohly líbit ještě více.
Pro spojení průzkumu a využívání znalostí použijeme ε-greedy, epsilon-hladový algoritmus. Nastavíme ε podle toho, jak často chceme volit náhodně. S pravděpodobností 1−ε vybere algoritmus nejlepší tah, tedy využije známé možnosti. S pravděpodobností ε zvolí náhodný tah, tedy zkoumá.
Další možností je poskytovat zpětnou vazbu až na konci celého procesu místo po každém tahu. Například ve hře Nim jsou objekty rozděleny do různě velkých hromádek. Každý hráč odebere libovolný počet objektů z jedné hromádky a hráč odebírající poslední objekt prohraje. Nenatrénovaná AI hraje náhodně a snadno ji porazíme. Při trénování začne náhodnými hrami a na konci dostane odměnu 1 za vítězství a −1 za prohru. Například po 10 000 hrách už je natolik schopná, že je těžké ji porazit.
U her s mnoha stavy a akcemi, například šachů, je tento přístup výpočetně náročnější. Není možné vytvářet odhad pro každý tah v každém stavu. Můžeme proto použít aproximaci funkce, která přibližně určuje Q(s, a) z různých dalších vlastností místo ukládání jedné hodnoty pro každou dvojici stav–akce. Algoritmus tak rozpozná dostatečně podobné tahy, které mají mít podobný odhad hodnoty, a tuto heuristiku využije při rozhodování.
Učení bez učitele
V předchozích příkladech, například při učení s učitelem, jsme měli data se štítky, ze kterých se algoritmus učil. U padělaných bankovek každá bankovka měla čtyři vstupní proměnné a štítek určující pravost či padělek. Při učení bez učitele máme pouze vstupy a AI v nich hledá vzory.
Shlukování
Shlukování je úloha učení bez učitele, která rozdělí vstupní data do skupin tak, aby podobné objekty patřily do stejné skupiny. Využívá se například v genetickém výzkumu při hledání podobných genů nebo v segmentaci obrázků při určování jejich částí podle podobnosti pixelů.
Shlukování metodou k-means
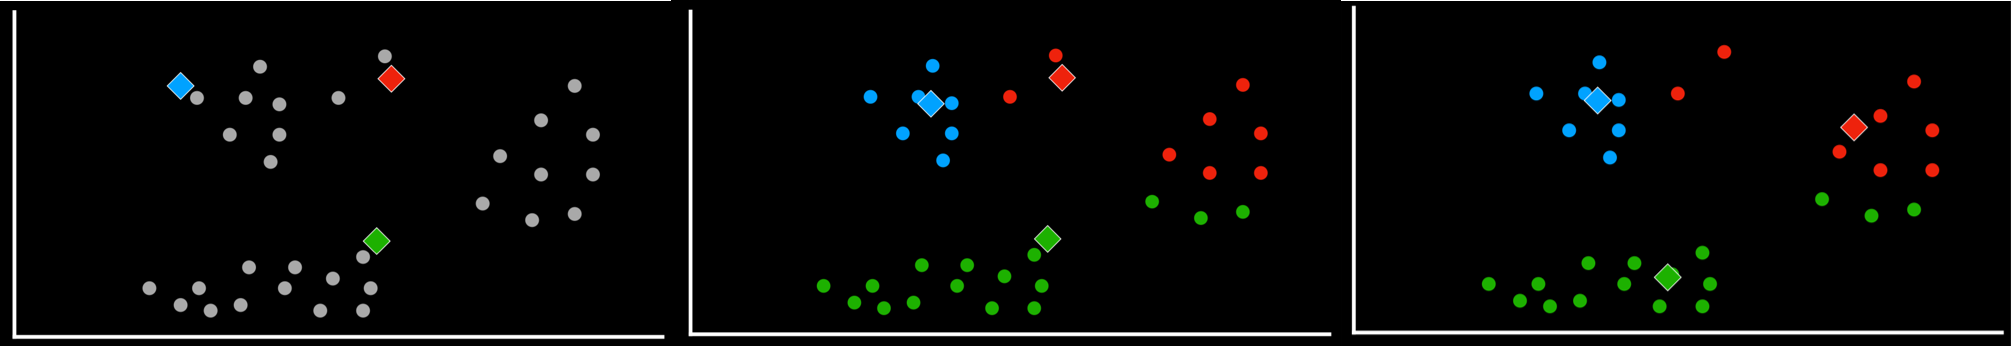
Algoritmus k-means rozmístí všechny datové body v prostoru a náhodně zvolí k středů shluků. Počet určuje programátor; počáteční stav vidíme vlevo. Každý střed je prostě bodem v prostoru. Poté každému shluku přiřadí body, které jsou jeho středu blíže než kterémukoli jinému, jak ukazuje prostřední obrázek. Následně se opakovaně střed přesune doprostřed těchto bodů, stav vpravo, a body se znovu přiřadí nejbližším středům. Jakmile po opakování zůstává každý bod ve stejném shluku jako předtím, dosáhli jsme rovnováhy. Algoritmus skončí a body jsou rozděleny do shluků.