Přednáška 5: Neuronové sítě
Neuronové sítě
Neuronové sítě v AI jsou inspirovány neurovědou. V mozku jsou neurony buňky propojené do sítí. Každý neuron může elektrické signály přijímat i vysílat. Když elektrický vstup, který neuron dostává, překročí určitou mez, neuron se aktivuje a vyšle elektrický signál dál.
Umělá neuronová síť je matematický model učení inspirovaný biologickými neuronovými sítěmi. Umělé neuronové sítě modelují matematické funkce, které převádějí vstupy na výstupy podle struktury a parametrů sítě. Struktura umělé neuronové sítě se utváří při trénování na datech.
Při použití v AI odpovídá jednotlivému neuronu jednotka propojená s dalšími jednotkami. Podobně jako v minulé přednášce může AI například převádět dva vstupy, x₁ a x₂, na rozhodnutí, zda dnes bude pršet. Minule jsme pro tuto hypotézu navrhli funkci h(x₁, x₂) = w₀ + w₁x₁ + w₂x₂. Hodnoty w₁ a w₂ jsou váhy upravující vstupy; w₀ je konstanta, označovaná také jako bias neboli posun, která upravuje hodnotu celého výrazu.
Aktivační funkce
Abychom podle funkce hypotézy rozhodli, zda bude pršet, potřebujeme pro její výstup stanovit nějaký práh.
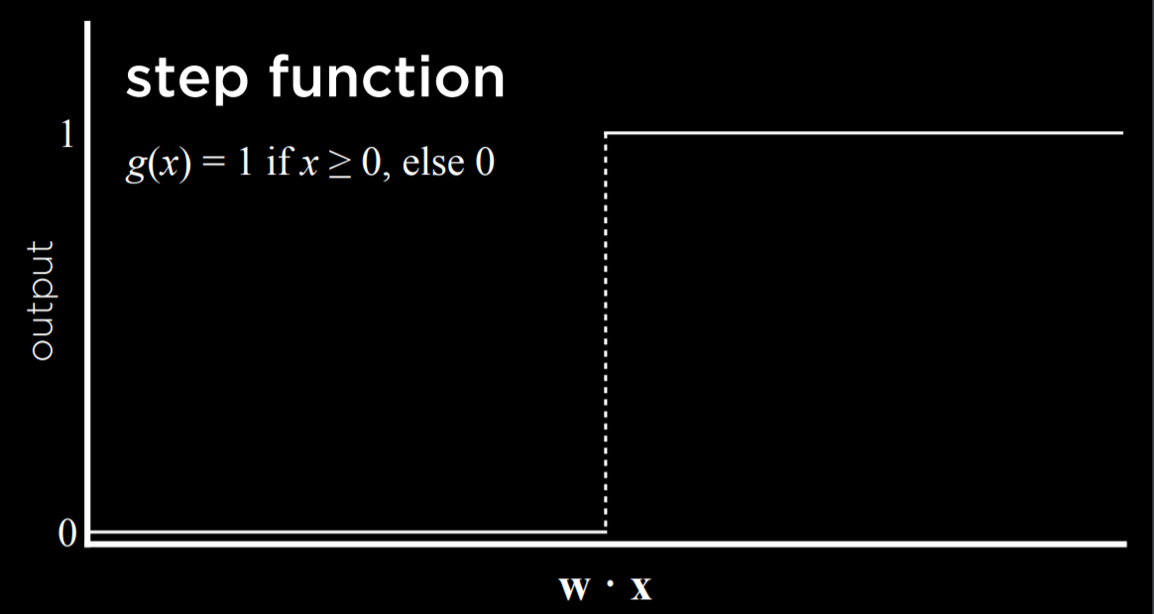
Jednou možností je skoková funkce: před dosažením určitého prahu vrací 0 a po jeho dosažení 1.
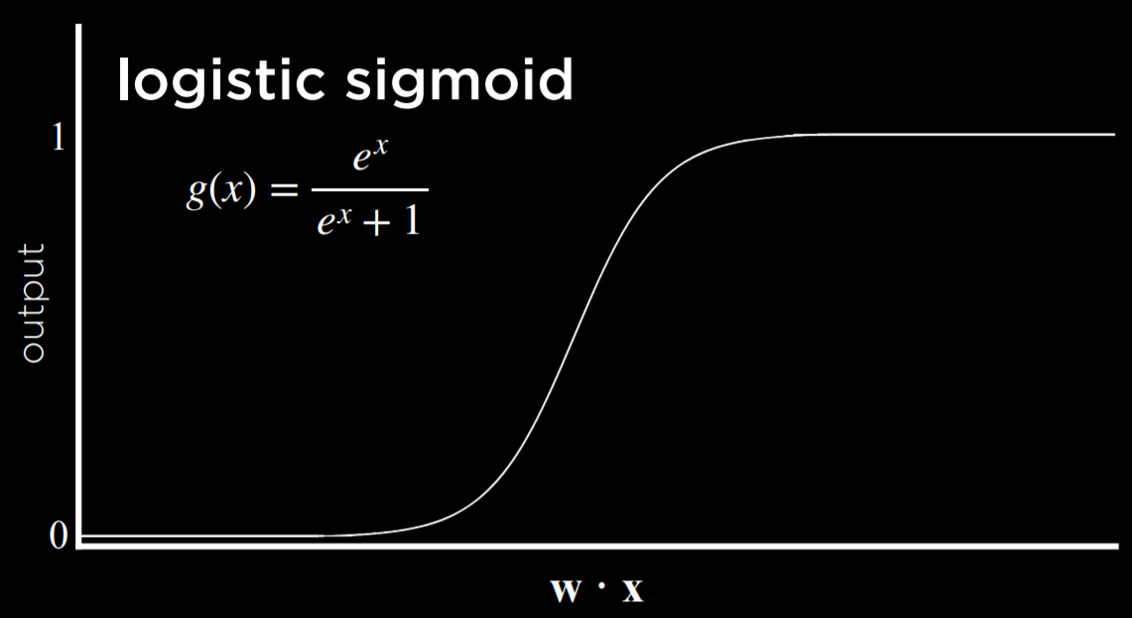
Další možností je logistická funkce. Jejím výstupem je libovolné reálné číslo od 0 do 1, takže dokáže vyjadřovat různou míru jistoty rozhodnutí.
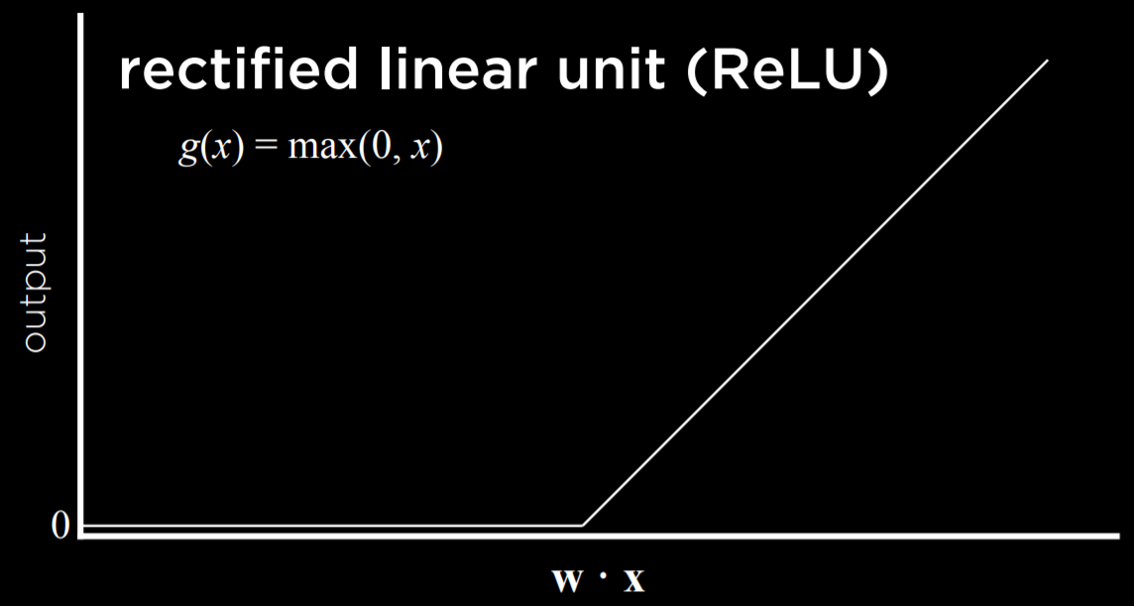
Další možnou funkcí je Rectified Linear Unit, zkráceně ReLU. Umožňuje libovolnou kladnou výstupní hodnotu. Záporné hodnoty převádí na 0.
Ať zvolíme kteroukoliv funkci, z minulé přednášky víme, že vstupy se upravují vahami a přidává se bias. Jejich součet se pak předává aktivační funkci. Totéž platí pro jednoduché neuronové sítě.
Struktura neuronové sítě
Neuronovou síť si můžeme představit jako vyjádření předchozího principu: funkce sečte vstupy a vytvoří výstup.

Dvě bílé jednotky vlevo představují vstup a jednotka vpravo výstup. Vstupy spojují s výstupem hrany s vahami. Při rozhodování výstupní jednotka vynásobí vstupy jejich vahami, přičte bias (w₀) a pomocí funkce g určí výstup.
Například logickou spojku Or, tedy „nebo“, lze vyjádřit jako funkci f s následující pravdivostní tabulkou:
| x | y | f(x, y) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 1 |
Tuto funkci můžeme zobrazit jako neuronovou síť. x₁ je jedna vstupní jednotka a x₂ druhá. S výstupní jednotkou je spojují hrany o váze 1. Výstupní jednotka potom používá funkci g(-1 + 1x₁ + 1x₂) s prahem 0 a vrací buď 0, nebo 1, tedy nepravdu či pravdu.

Pokud například x₁ = x₂ = 0, součet je (-1). To je pod prahem, a funkce g proto vrátí 0. Jestliže je ale jeden nebo oba vstupy x₁ a x₂ rovny 1, součet všech vstupů bude 0 nebo 1. Obě hodnoty dosahují prahu nebo jej překračují, takže funkce vrátí 1.
Podobný postup lze použít pro funkci And, tedy „a“, kde bias bude (-2). Vstupy a výstupy navíc nemusí být diskrétní. Podobným způsobem můžeme přijmout vlhkost a tlak vzduchu jako vstupy a získat pravděpodobnost deště jako výstup. V jiném příkladu mohou být vstupy peníze vydané na reklamu a měsíc, kdy byly vydány, a výstupem očekávané tržby. Postup lze rozšířit na libovolný počet vstupů: každý vstup x₁ … xₙ vynásobíme váhou w₁ … wₙ, výsledné hodnoty sečteme a přidáme bias w₀.
Gradientní sestup
Gradientní sestup je algoritmus pro minimalizaci ztráty při trénování neuronových sítí. Jak už zaznělo, neuronová síť dokáže z dat odvozovat informace o vlastní struktuře. Dosud jsme různé váhy určovali sami; neuronové sítě nám umožňují vypočítat je na základě trénovacích dat. Používáme k tomu algoritmus gradientního sestupu, který funguje takto:
- Začneme náhodně zvolenými vahami. To je náš počáteční, neinformovaný odhad, kdy ještě nevíme, jakou váhu jednotlivým vstupům přiřadit.
- Opakujeme:
- Ze všech datových bodů vypočítáme gradient, který povede ke snížení ztráty. Gradient je vektor, tedy posloupnost čísel.
- Podle gradientu aktualizujeme váhy.
Problém tohoto algoritmu je v tom, že vyžaduje výpočet gradientu ze všech datových bodů, což je výpočetně nákladné. Náklady lze snižovat různými způsoby. Například při stochastickém gradientním sestupu vypočítáme gradient z jednoho náhodně vybraného bodu. Takový gradient může být poměrně nepřesný. Proto existuje gradientní sestup s malými dávkami (mini-batch), který gradient počítá z několika náhodně vybraných bodů a představuje kompromis mezi výpočetními náklady a přesností. Jak tomu často bývá, žádné řešení není dokonalé a v různých situacích se mohou používat různé postupy.
Pomocí gradientního sestupu můžeme hledat odpovědi na mnoho problémů. Například nás může zajímat více než pouze „Bude dnes pršet?“. Z určitých vstupů můžeme vytvořit pravděpodobnosti různých druhů počasí a pak zvolit ten nejpravděpodobnější.
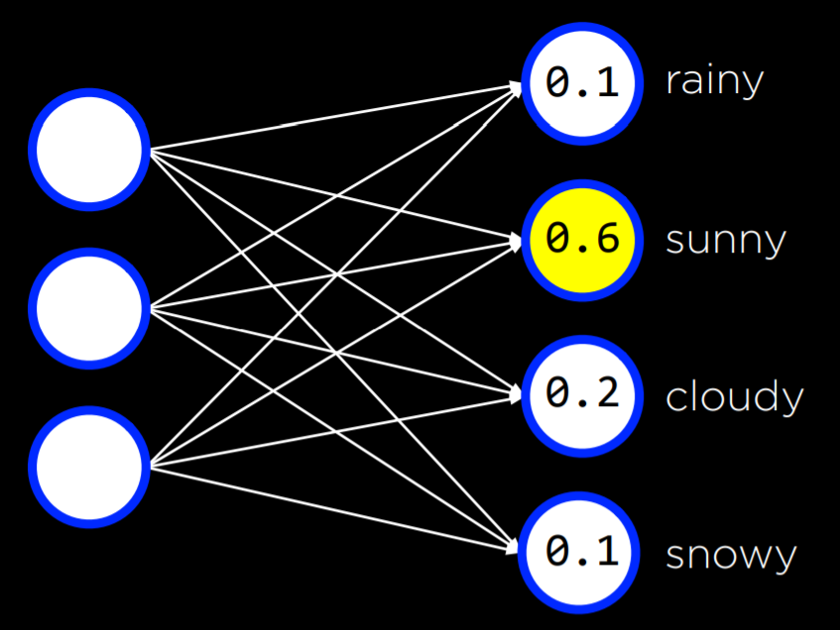
Takto lze pracovat s libovolným počtem vstupů a výstupů. Každý vstup je propojen s každým výstupem a výstupy představují rozhodnutí, která můžeme udělat. Všimněte si, že v tomto druhu sítě nejsou výstupy vzájemně propojené. Každý výstup a váhy všech vstupů, které k němu vedou, proto můžeme chápat jako samostatnou neuronovou síť a trénovat jej odděleně od ostatních výstupů.
Dosud naše neuronové sítě používaly výstupní jednotky typu perceptron. Ty se dokážou naučit jen lineární rozhodovací hranici, tedy oddělit data přímkou. Na základě lineární rovnice může perceptron zařadit vstup do jednoho nebo druhého typu, jak ukazuje obrázek vlevo. Data však často nejsou lineárně oddělitelná, jak ukazuje obrázek vpravo. V takovém případě používáme vícevrstvé neuronové sítě, které data modelují nelineárně.

Vícevrstvé neuronové sítě
Vícevrstvá neuronová síť je umělá neuronová síť se vstupní vrstvou, výstupní vrstvou a alespoň jednou skrytou vrstvou. Při trénování modelu dodáváme vstupy a výstupy, ale my lidé neposkytujeme žádné hodnoty jednotkám uvnitř skrytých vrstev. Každá jednotka první skryté vrstvy dostává hodnotu s příslušnou vahou od každé jednotky vstupní vrstvy, provede s ní nějakou operaci a vytvoří výstup. Každá z těchto hodnot se opět násobí vahou a předává další vrstvě. Proces se opakuje až do výstupní vrstvy. Skryté vrstvy umožňují modelovat nelineární data.

Zpětné šíření chyby (backpropagation)
Zpětné šíření chyby je hlavní algoritmus používaný k trénování neuronových sítí se skrytými vrstvami. Začíná chybami výstupních jednotek, vypočítává gradient pro váhy předchozí vrstvy a tento proces opakuje až ke vstupní vrstvě. V pseudokódu jej můžeme popsat takto:
- Vypočítáme chybu výstupní vrstvy.
- Pro každou vrstvu, počínaje výstupní a postupující dovnitř k nejstarší skryté vrstvě:
- Předáme chybu o jednu vrstvu zpět. Jinými slovy, právě zpracovávaná vrstva pošle chyby předchozí vrstvě.
- Aktualizujeme váhy.
Tento postup lze rozšířit na libovolný počet skrytých vrstev. Vznikají tak hluboké neuronové sítě, které mají více než jednu skrytou vrstvu.

Přeučení
Přeučení nastává, když model příliš těsně kopíruje trénovací data a potom nedokáže zobecňovat na nová data. Jedním způsobem, jak mu bránit, je dropout. Při této technice v průběhu učení dočasně vyřazujeme náhodně vybrané jednotky. Snažíme se tím zabránit přílišnému spoléhání na jedinou jednotku sítě. Během trénování tak síť nabývá různých podob: pokaždé vyřadí jiné jednotky a později je znovu použije.
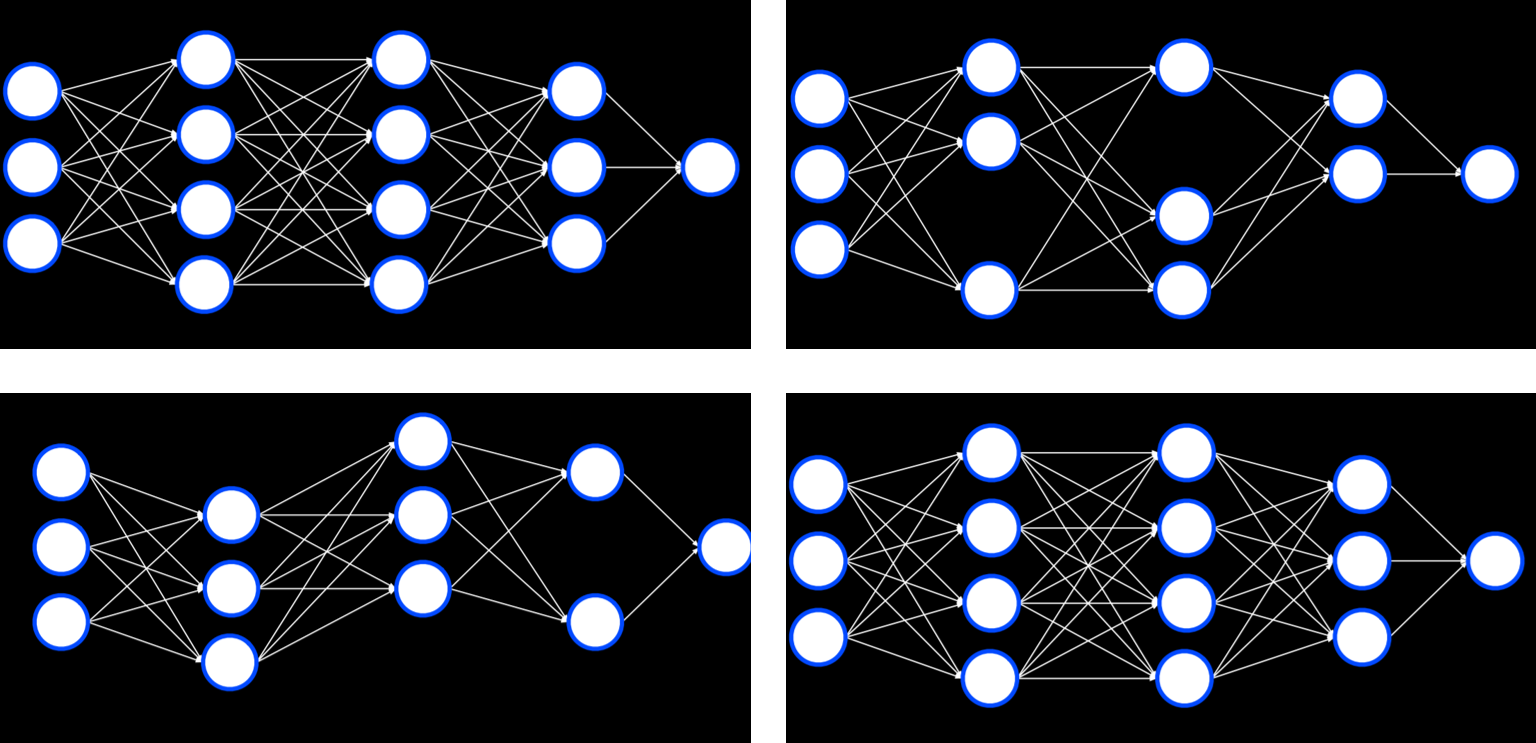
Po dokončení trénování se opět používá celá neuronová síť.
TensorFlow
Jak tomu v Pythonu často bývá, několik knihoven už obsahuje implementaci neuronových sítí využívající zpětné šíření chyby. Jednou z nich je TensorFlow. Se sítěmi TensorFlow můžete experimentovat v této webové aplikaci: nastavíte různé vlastnosti sítě, spustíte ji a zobrazíte výstupy. Nyní přejdeme k příkladu použití TensorFlow pro úlohu z minulé přednášky, tedy rozlišování padělaných a pravých bankovek.
import csv
import tensorflow as tf
from sklearn.model_selection import train_test_split
Importujeme TensorFlow a nazveme jej tf, aby byl kód kratší.
# Read data in from file
with open("banknotes.csv") as f:
    reader = csv.reader(f)
    next(reader)

    data = []
    for row in reader:
        data.append({
            "evidence": [float(cell) for cell in row[:4]],
            "label": 1 if row[4] == "0" else 0
        })

# Separate data into training and testing groups
evidence = [row["evidence"] for row in data]
labels = [row["label"] for row in data]
X_training, X_testing, y_training, y_testing = train_test_split(
    evidence, labels, test_size=0.4
)
Modelu předáme data z CSV. Naše práce často spočívá v přizpůsobení dat formátu, který knihovna vyžaduje. Obtížná část implementace samotného modelu už je připravena za nás.
# Create a neural network
model = tf.keras.models.Sequential()
Keras je API používané různými algoritmy strojového učení. Sekvenční model je takový model, v němž vrstvy následují jedna po druhé, podobně jako v dosavadních příkladech.
# Add a hidden layer with 8 units, with ReLU activation
model.add(tf.keras.layers.Dense(8, input_shape=(4,), activation="relu"))
Plně propojená vrstva (dense layer) propojuje každý uzel aktuální vrstvy se všemi uzly vrstvy předchozí. Zde vytvoříme plně propojenou vrstvu s 8 jednotkami, přičemž každá má 4 vstupní neurony, a použijeme výše popsanou aktivační funkci ReLU.
# Add output layer with 1 unit, with sigmoid activation
model.add(tf.keras.layers.Dense(1, activation="sigmoid"))
Ve výstupní vrstvě chceme vytvořit jednu plně propojenou vrstvu se sigmoidní aktivační funkcí. Její výstup je hodnota mezi 0 a 1.
# Train neural network
model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"]
)
model.fit(X_training, y_training, epochs=20)

# Evaluate how well model performs
model.evaluate(X_testing, y_testing, verbose=2)
Nakonec model zkompilujeme: určíme algoritmus pro optimalizaci, druh ztrátové funkce a způsob měření úspěchu. V našem případě nás zajímá přesnost výstupu. Model potom trénujeme na trénovacích datech ve 20 opakováních neboli epochách a vyhodnotíme jej na testovacích datech.
Počítačové vidění
Počítačové vidění zahrnuje různé výpočetní metody pro analýzu digitálních obrázků a porozumění jejich obsahu. Často využívá neuronové sítě. Příkladem je rozpoznávání obličejů na sociálních sítích při automatickém označování lidí na fotografiích. Dalšími příklady jsou rozpoznávání rukopisu a samořiditelná auta.
Obrázky se skládají z pixelů. Pixel můžeme reprezentovat třemi hodnotami v rozsahu od 0 do 255: jednou pro červenou, jednou pro zelenou a jednou pro modrou. Tyto hodnoty se běžně označují zkratkou RGB. Můžeme vytvořit neuronovou síť, v níž je každá barevná hodnota každého pixelu vstupem, následují skryté vrstvy a výstup tvoří jednotky určující, co je na obrázku. Tento přístup má ovšem několik nevýhod. Zaprvé rozložením obrázku na pixely a jejich barevné hodnoty nevyužíváme jeho strukturu. Člověk například po zahlédnutí části obličeje očekává i jeho zbytek, což zpracování urychluje. Podobnou výhodu bychom chtěli využít v síti. Zadruhé je samotný počet vstupů velmi velký, a museli bychom tedy počítat velké množství vah.
Konvoluce obrazu
Konvoluce obrazu aplikuje filtr, který kombinuje hodnotu pixelu s hodnotami jeho sousedů podle vah v matici jádra (kernel). Tím obrázek mění a může neuronové síti usnadnit jeho zpracování.
Podívejme se na následující příklad:
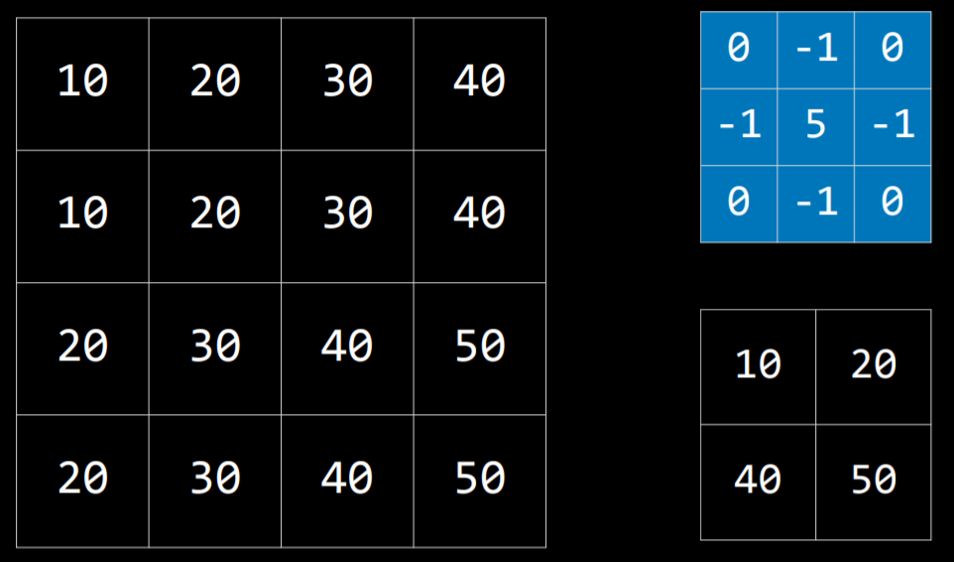
Jádro je modrá matice a obrázek velká matice vlevo. Výsledný filtrovaný obrázek je malá matice vpravo dole. Při filtrování začneme pixelem o hodnotě 20 v levé horní části obrázku, na souřadnicích 1,1. Všechny hodnoty v jeho okolí vynásobíme odpovídajícími hodnotami jádra a sečteme: 10*0 + 20*(-1) + 30*0 + 10*(-1) + 20*5 + 30*(-1) + 20*0 + 30*(-1) + 40*0. Dostaneme hodnotu 10. Totéž uděláme pro pixel napravo (30), pixel pod prvním pixelem (30) a pixel napravo od něj (40). Vznikne filtrovaný obrázek s hodnotami vpravo dole.
Různá jádra mohou plnit různé úkoly. K detekci hran se často používá následující jádro:
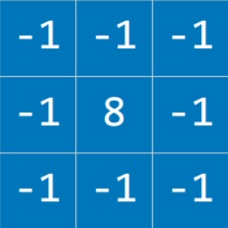
Princip je takový, že pokud je pixel podobný všem sousedům, jejich příspěvky se vzájemně vyruší a výsledkem bude 0. Čím jsou si pixely podobnější, tím bude daná oblast tmavší; čím se více liší, tím bude světlejší. Použitím tohoto jádra na obrázek vlevo dostaneme obrázek se zvýrazněnými hranami vpravo.

Podívejme se na implementaci konvoluce. Používáme knihovnu PIL, zkratku Python Imaging Library, která za nás zvládne většinu náročné práce.
import math
import sys

from PIL import Image, ImageFilter

# Ensure correct usage
if len(sys.argv) != 2:
    sys.exit("Usage: python filter.py filename")

# Open image
image = Image.open(sys.argv[1]).convert("RGB")

# Filter image according to edge detection kernel
filtered = image.filter(ImageFilter.Kernel(
    size=(3, 3),
    kernel=[-1, -1, -1, -1, 8, -1, -1, -1, -1],
    scale=1
))

# Show resulting image
filtered.show()
Zpracování obrázku v neuronové síti je stále výpočetně nákladné kvůli počtu vstupních pixelů. Další možností je pooling, při němž zmenšujeme vstup vybíráním hodnot z jeho oblastí. Sousední pixely patří do stejné oblasti obrázku, a proto bývají podobné. Jeden pixel tak může zastoupit celou oblast. Jedním postupem je max-pooling: z každé oblasti vybereme pixel s nejvyšší hodnotou. Rozdělíme-li například čtverec vlevo na čtyři čtverce o velikosti 2×2 a provedeme max-pooling, získáme malý čtverec vpravo.

Konvoluční neuronové sítě
Konvoluční neuronová síť využívá konvoluci, obvykle při analýze obrázků. Nejprve aplikuje filtry s různými jádry, které pomáhají vytáhnout určité vlastnosti obrázku. Tyto filtry lze zlepšovat stejně jako jiné váhy sítě: upravovat jejich jádra podle chyby výstupu. Výsledné obrázky následně projdou poolingem a jejich pixely se předají jako vstupy běžné neuronové síti. Tento poslední krok se označuje jako flattening, tedy zploštění do jednorozměrného vstupu.
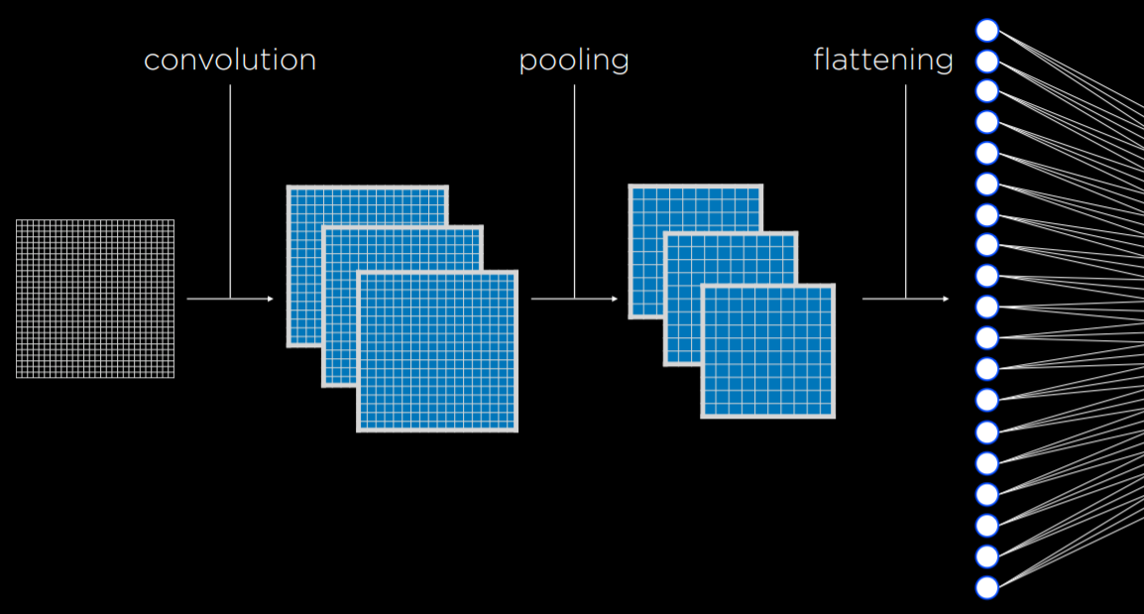
Konvoluci a pooling lze několikrát opakovat, aby síť získala další vlastnosti a zmenšila velikost vstupu. Výhodou je menší citlivost na drobné změny. Pokud například pořídíme tentýž obrázek z mírně odlišných úhlů, vstupy konvoluční sítě si budou podobné. Bez konvoluce a poolingu by se vstupy z jednotlivých obrázků výrazně lišily.
V kódu se konvoluční neuronová síť od běžné sítě příliš neliší. TensorFlow nabízí datové sady pro testování modelů. Použijeme MNIST, který obsahuje černobílé obrázky ručně psaných číslic, a naučíme síť tyto číslice rozpoznávat.
import sys
import tensorflow as tf

# Use MNIST handwriting dataset
mnist = tf.keras.datasets.mnist

# Prepare data for training
(x_train, y_train), (x_test, y_test) = mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0
y_train = tf.keras.utils.to_categorical(y_train)
y_test = tf.keras.utils.to_categorical(y_test)
x_train = x_train.reshape(
    x_train.shape[0], x_train.shape[1], x_train.shape[2], 1
)
x_test = x_test.reshape(
    x_test.shape[0], x_test.shape[1], x_test.shape[2], 1
)

# Create a convolutional neural network
model = tf.keras.models.Sequential([

    # Convolutional layer. Learn 32 filters using a 3x3 kernel
    tf.keras.layers.Conv2D(
        32, (3, 3), activation="relu", input_shape=(28, 28, 1)
    ),

    # Max-pooling layer, using 2x2 pool size
    tf.keras.layers.MaxPooling2D(pool_size=(2, 2)),

    # Flatten units
    tf.keras.layers.Flatten(),

    # Add a hidden layer with dropout
    tf.keras.layers.Dense(128, activation="relu"),
    tf.keras.layers.Dropout(0.5),

    # Add an output layer with output units for all 10 digits
    tf.keras.layers.Dense(10, activation="softmax")
])

# Train neural network
model.compile(
    optimizer="adam",
    loss="categorical_crossentropy",
    metrics=["accuracy"]
)
model.fit(x_train, y_train, epochs=10)

# Evaluate neural network performance
model.evaluate(x_test,  y_test, verbose=2)
Protože trénování nějakou dobu trvá, můžeme už natrénovaný model uložit a použít později.
# Save model to file
if len(sys.argv) == 2:
    filename = sys.argv[1]
    model.save(filename)
    print(f"Model saved to {filename}.")
Pokud nyní spustíme program přijímající ručně nakreslené číslice, dokáže je pomocí modelu zařadit a vypsat rozpoznanou číslici. Implementaci takového programu najdete v souboru recognition.py ve zdrojových kódech této přednášky.
Rekurentní neuronové sítě
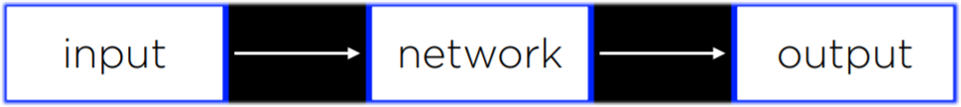
Dopředné neuronové sítě (feed-forward) jsou sítě, které jsme dosud probírali: přijmou vstupní data a nakonec vytvoří výstup. Jejich fungování ukazuje následující schéma.
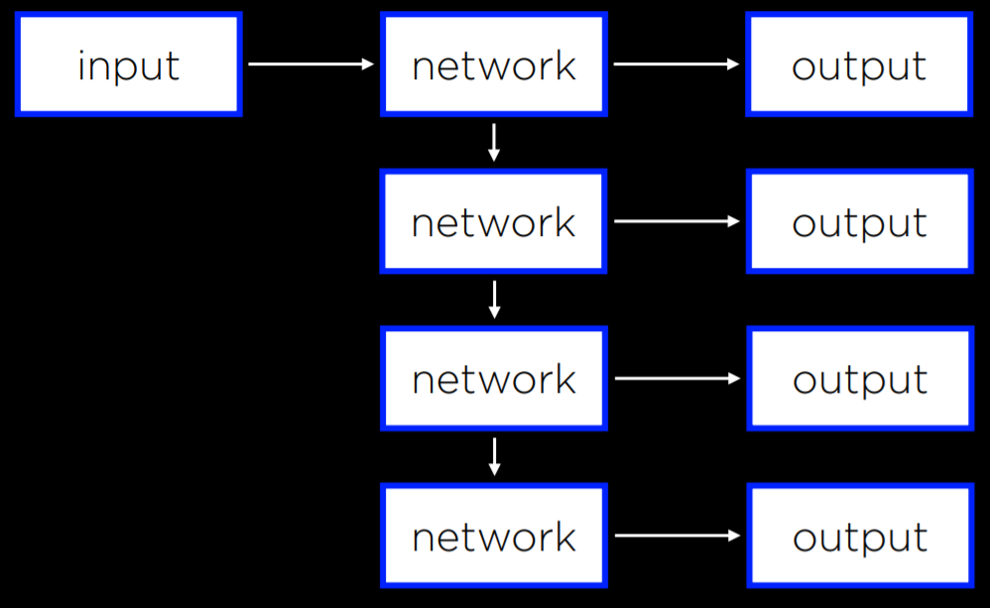
Rekurentní neuronové sítě oproti tomu používají strukturu se zpětnými vazbami, v níž síť využívá vlastní výstup jako vstup. Například captionbot od Microsoftu dokáže popsat obsah obrázku slovy ve větě. To se od klasifikace liší tím, že délka výstupu závisí na vlastnostech obrázku. Běžné dopředné sítě mají pevný počet výstupů; rekurentní síť může díky své struktuře vytvářet různě dlouhou posloupnost. Při popisování obrázku zpracuje vstup, vytvoří výstup a pokračuje z tohoto stavu dalším výstupem. Postup opakuje, dokud je to potřeba.
Rekurentní neuronové sítě jsou užitečné při práci s posloupnostmi, nikoli pouze s jednotlivým objektem. V předchozím příkladu vytvářela síť posloupnost slov. Stejný princip lze použít při analýze videí tvořených posloupností obrázků nebo při překladu, kdy se posloupnost vstupů, tedy slov ve zdrojovém jazyce, převádí na posloupnost výstupů, tedy slov v cílovém jazyce.