Projekt 6 — Pozornost (Attention)
Nejnovější verze Pythonu, kterou bys měla v tomto kurzu používat, je Python 3.12.
Napiš AI, která předpoví maskované slovo v textové posloupnosti.
$ python mask.py
Text: We turned down a narrow lane and passed through a small [MASK].
We turned down a narrow lane and passed through a small field.
We turned down a narrow lane and passed through a small clearing.
We turned down a narrow lane and passed through a small park.

$ python mask.py
Text: Then I picked up a [MASK] from the table.
Then I picked up a book from the table.
Then I picked up a bottle from the table.
Then I picked up a plate from the table.
Kdy úlohu dokončit
Jak získat pomoc
- Ptej se prostřednictvím Ed!
- Ptej se v kterékoli komunitě CS50!
Východiska
Jedním způsobem tvorby jazykových modelů je Masked Language Model: model trénujeme k předpovědi „maskovaného“ slova chybějícího v textu. BERT je jazykový model s transformery vyvinutý Googlem a trénovaný právě takto: maskované slovo předpovídá podle okolních slov.
BERT má architekturu transformeru a pro porozumění jazyku používá mechanismus attention, pozornosti. Základní BERT má 12 vrstev, každou s 12 hlavami self-attention, celkem tedy 144 hlav.
Projekt má dvě části:
Nejprve pomocí knihovny Pythonu transformers společnosti Hugging Face napíšeme program, který pomocí BERT předpovídá maskovaná slova. Zároveň vytvoří diagramy hodnot attention, jeden pro každou ze 144 hlav.
Potom diagramy analyzujeme a pokusíme se pochopit, čemu mohou hlavy BERT věnovat pozornost při porozumění přirozenému jazyku.
Začínáme
- Stáhni dodaný kód z https://cdn.cs50.net/ai/2023/x/projects/6/attention.zip a rozbal jej.
- Ve složce
attentionspusťpip3 install -r requirements.txtpro instalaci závislostí projektu.
Porozumění zadání
Nejprve prohlédni mask.py. Funkce main požádá uživatele o text. Ten má obsahovat token [MASK] za slovo, které model předpoví. Pomocí AutoTokenizer potom funkce rozdělí vstup na tokeny.
Každý odlišný token BERT má vlastní číselné ID. tokenizer.mask_token_id je ID tokenu [MASK]. Většina dalších tokenů odpovídá slovům, s výjimkami. [CLS] je vždy na začátku textu, [SEP] na konci a odděluje posloupnosti. Jedno slovo se někdy rozdělí na více tokenů: „intelligently“ BERT rozděluje na intelligent a ##ly.
Potom instance TFBertForMaskedLM předpoví maskovaný token pomocí BERT. Vstupní tokeny inputs předáme modelu a vyhledáme nejlepších K výstupních tokenů. Vypíšeme původní text s maskou nahrazenou postupně každou předpovědí.
Nakonec visualize_attentions vytvoří diagramy hodnot attention pro vstupní posloupnost a každou hlavu BERT.
Většina kódu je hotová, ale get_mask_token_index, get_color_for_attention_score a visualize_attentions musíš implementovat!
Po dokončení těchto tří funkcí vytváří mask.py diagramy attention. Ukazují něco z toho, na co se BERT naučil zaměřovat při zpracování jazyka. Níže například vidíš diagram vrstvy 3, hlavy 10 pro větu „Then I picked up a [MASK] from the table.“.
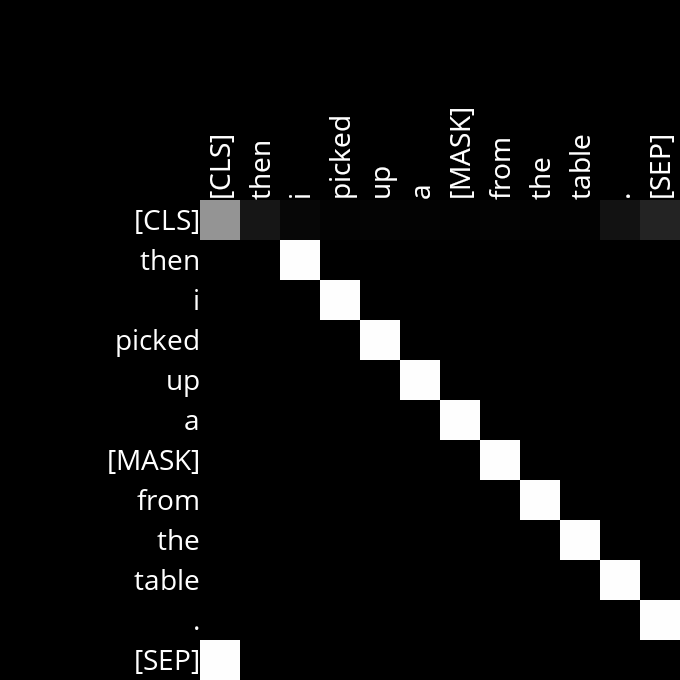
Světlejší barvy znamenají vyšší váhu attention a tmavší nižší. Tato hlava se zřejmě naučila velmi zřetelný vzor: každé slovo se zaměřuje na bezprostředně následující slovo. „then“ například odpovídá druhému řádku diagramu, kde je nejsvětlejší buňka ve sloupci „i“. To naznačuje, že „then“ silně zaměřuje pozornost na „i“. Totéž platí pro ostatní tokeny věty.
Spuštěním mask.py na dalších větách můžeš ověřit, zda vrstva 3, hlava 10 tento vzor opakuje. Intuitivně to dává smysl: porozumění slovu často závisí na slovu následujícím. Jedna či více hlav zaměřených na následující slovo tedy může být užitečná.
Tato hlava je obzvlášť zřetelná, ale jiné bývají zašuměné a odhad jejich zaměření vyžaduje větší interpretační úsilí.
Představme si, že nás zajímá role příslovcí. Modelu zadáme „The turtle moved slowly across the [MASK].“ a v diagramech hledáme, zda si všiml, že „slowly“ je příslovce rozvíjející „moved“. Zaujmout nás může vrstva 4, hlava 11.
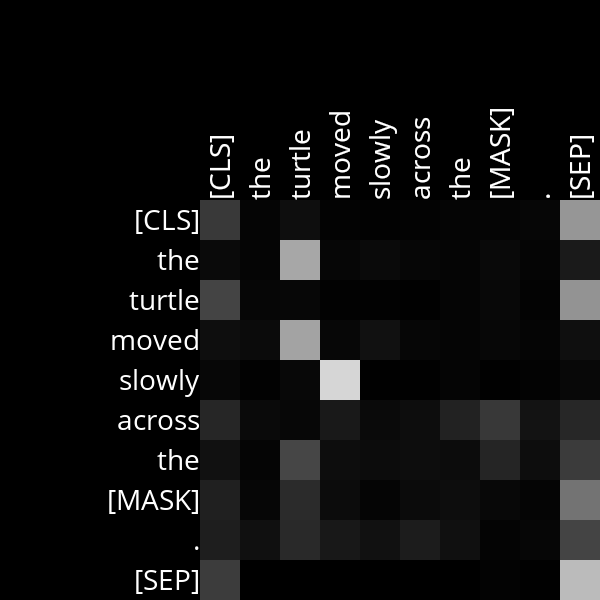
Tato hlava je mnohem zašuměnější a její funkce není hned patrná. U příslovce „slowly“ však nejvíc zaměřuje pozornost na rozvíjené sloveso „moved“. Platí to i po prohození pořadí slovesa a příslovce.
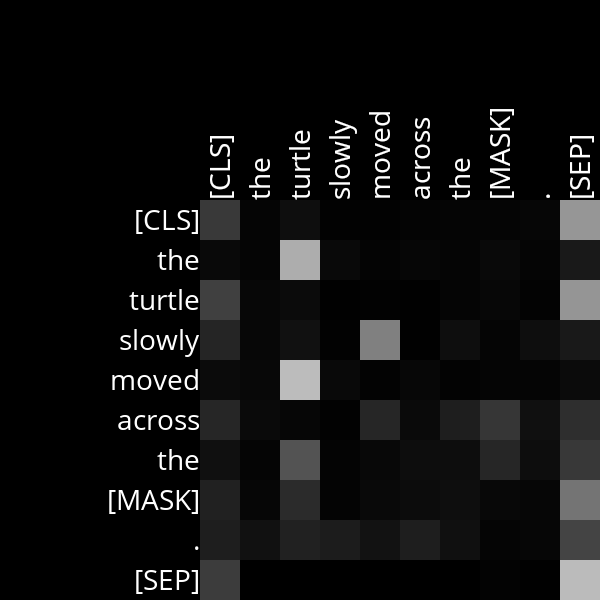
Zdá se to platit i ve větě, kde příslovce a rozvíjené sloveso neleží těsně vedle sebe.
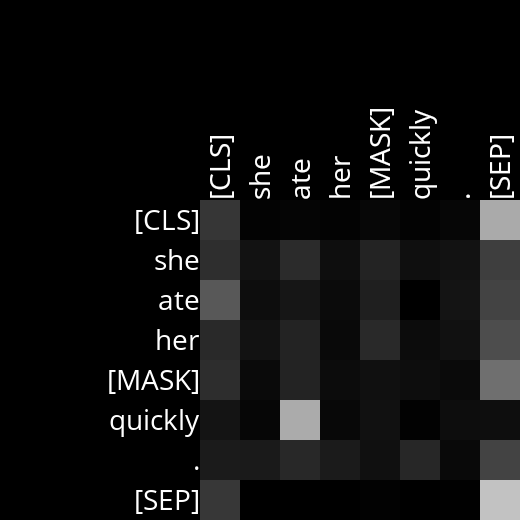
Můžeme tedy rozumně odhadnout, že se hlava naučila vztah příslovcí a rozvíjených slov. Attention vrstvy nebudou vždy odpovídat našim očekáváním pro konkrétní vztah a někdy ani žádnému lidsky interpretovatelnému vztahu. Přesto můžeme podle pozorovaného chování formulovat odhady; právě to budeš dělat v tomto projektu.
Specifikace
Nejprve dokonči get_mask_token_index, get_color_for_attention_score a visualize_attentions.
get_mask_token_indexpřijme ID maskovacího tokenu typuinta vstup tokenizátoruinputstyputransformers.BatchEncoding. Vrátí index maskovacího tokenu ve vstupní posloupnosti.- Indexování je od nuly. Pokud je například třetí vstupní ID maskou, vrať
2. - Pokud vstup maskovací token neobsahuje, vrať
None. - Můžeš předpokládat nejvýše jednu masku ve vstupu.
- V dokumentaci
transformersprohlédni zejména návratovou hodnotu volání tokenizátoru: zjistíš, jaká poleBatchEncodingnabízí k přístupu.
- Indexování je od nuly. Pokud je například třetí vstupní ID maskou, vrať
get_color_for_attention_scorepřijme hodnotu attention mezi0a1včetně a vrátí tuple tří celých čísel RGB, červené, zelené a modré, určujících barvu odpovídající buňky diagramu.- Při attention
0musí být barva černá,(0, 0, 0). Při1bílá,(255, 255, 255). Mezi nimi má být odstín šedi lineárně odpovídající hodnotě attention. - Pro odstín šedi musí být červená, modrá a zelená hodnota stejné.
- Všechny hodnoty jsou celá čísla, ale můžeš zvolit oříznutí či zaokrouhlení. Pro
0.25lze například vrátit(63, 63, 63)i(64, 64, 64), protože 25 % z 255 je 63,75.
- Při attention
visualize_attentionspřijímá posloupnosttokens, seznam řetězců, aattentionsse všemi hodnotami modelu. Pro každou hlavu vytvoří diagram, například volánímgenerate_diagram.attentionsje tuple tensorů; tensor zde můžeš chápat jako vícerozměrné pole.- Ke konkrétní hlavě v
attentionspřistoupíš přesattentions[i][j][k], kdeije index vrstvy,jindex beam, v našem případě vždy0, akindex hlavy ve vrstvě. - Dosavadní implementace vytváří jediný diagram pro první hlavu první vrstvy. Rozšiř ji na všechny hlavy a vrstvy.
- První dva argumenty
generate_diagramjsou číslo vrstvy a hlavy, indexované od jedné. Pro první hlavu první vrstvy, obě s indexem 0, tedylayer_numberje1ahead_numbertaké1.
Po dokončení tří funkcí můžeš spustit mask.py a předpovídat maskovaná slova i vytvářet diagramy. Ve druhé části analyzuješ diagramy vět podle vlastního výběru a odhaduješ úlohu konkrétních hlav při porozumění jazyku. Analýzu vyplníš v analysis.md.
- Dokonči
TODOsvanalysis.md.- Popiš alespoň dvě hlavy, u nichž jsi identifikovala vztah slov, kterému se hlava zřejmě naučila. U každé jednou či dvěma větami vysvětli pozorované zaměření a uveď alespoň dvě příkladové věty zadané modelu, které tě k závěru vedly.
- Část „Porozumění zadání“ obsahuje dva příklady: vrstvu 3, hlavu 10 se zaměřením na následující tokeny, a vrstvu 4, hlavu 11, kde příslovce míří ke slovesům, která rozvíjejí. Tebou identifikované jazykové vztahy musejí být jiné než tyto dva.
- Hlavy bývají zašuměné a ne vždy mají jasnou lidskou interpretaci. Někdy se zaměřují i mimo popsaný vztah a někdy jej nezachytí v každé větě. To je v pořádku! Cílem je odhadovat attention pomocí lidské jazykové intuice, nikoli nutně přesně identifikovat úlohu každé hlavy.
- Hledej libovolný vztah slov, který tě zajímá. Pro inspiraci zvaž vztahy sloves a přímých předmětů, předložek, zájmen, přídavných jmen, determinátorů nebo zaměření tokenů na předcházející tokeny.
Tipy
- Při analýze často zjistíš, že mnoho tokenů v mnoha hlavách silně směřuje k
[SEP]nebo[CLS]. Může to nastat, pokud hlava nemá vhodné slovo, na něž by se zaměřila.
Testování
Chceš-li vyhodnotit správnost kódu, můžeš po nastavení check50 spustit následující příkaz. Není to povinné: při odevzdání podle kroků na konci zadání proběhnou stejné testy na našem serveru. V každém případě kód také sama zkompiluj a otestuj!
check50 ai50/projects/2024/x/attention
Následujícím příkazem vyhodnotíš styl kódu pomocí style50.
style50 mask.py
Pamatuj, že kromě standardní knihovny Pythonu nesmíš importovat žádné moduly mimo ty, které jsou zde výslovně povoleny. Jinak nebude fungovat check50 a ani submit50 nebude moci práci ohodnotit, protože používá check50. Pokud se to stane, patrně jsi importovala zakázaný modul nebo nepovoleně upravila dodaný kód. Existují nástroje, které některé projekty velmi zjednodušují, ale to zde není cílem: učíš se principům na nižší úrovni. Pokud zde jejich použití nepovolujeme, použít je nemůžeš.
Jak odevzdat
- Otevři tento odkaz, přihlas se účtem GitHub a klikni na Authorize cs50. Pak zaškrtni souhlas s přístupem učitelů k odevzdaným pracím a klikni na Join course.
- Nainstaluj Git a případně nainstaluj
submit50. - Pokud máš nainstalované
submit50, spusťsubmit50 ai50/projects/2024/x/attentionJinak pomocí Gitu odešli práci do
https://github.com/me50/USERNAME.git, kdeUSERNAMEje tvoje jméno na GitHubu, na větevai50/projects/2024/x/attention.
Při přímém odevzdání přes Git místo submit50 nepřikládej soubory ani složky mimo ty, které máš podle zadání upravit. Neodesílej tedy celý adresář!
Práce by měla být ohodnocena do pěti minut. Svůj postup pak můžeš sledovat na https://cs50.me/cs50ai!