Přednáška 3
Optimalizace
Optimalizace znamená výběr nejlepší možnosti z množiny dostupných možností. S problémy, v nichž jsme hledali nejlepší možnou variantu, jsme se už setkali například u algoritmu minimax. Dnes se naučíme nástroje, kterými lze řešit ještě širší okruh problémů.
Lokální prohledávání
Lokální prohledávání je vyhledávací algoritmus, který udržuje jediný uzel a postupuje přesunem do sousedního uzlu. Liší se od dříve probíraných způsobů hledání. Při hledání cesty bludištěm jsme například chtěli nejrychleji dojít k cíli, zatímco lokální prohledávání hledá nejlepší odpověď na otázku. Často nalezne odpověď, která není optimální, ale je „dost dobrá“, a ušetří tím výpočetní prostředky. Uvažujme tento příklad: čtyři domy stojí na určených místech. Chceme postavit dvě nemocnice tak, abychom minimalizovali vzdálenost každého domu k nemocnici. Problém lze znázornit takto:
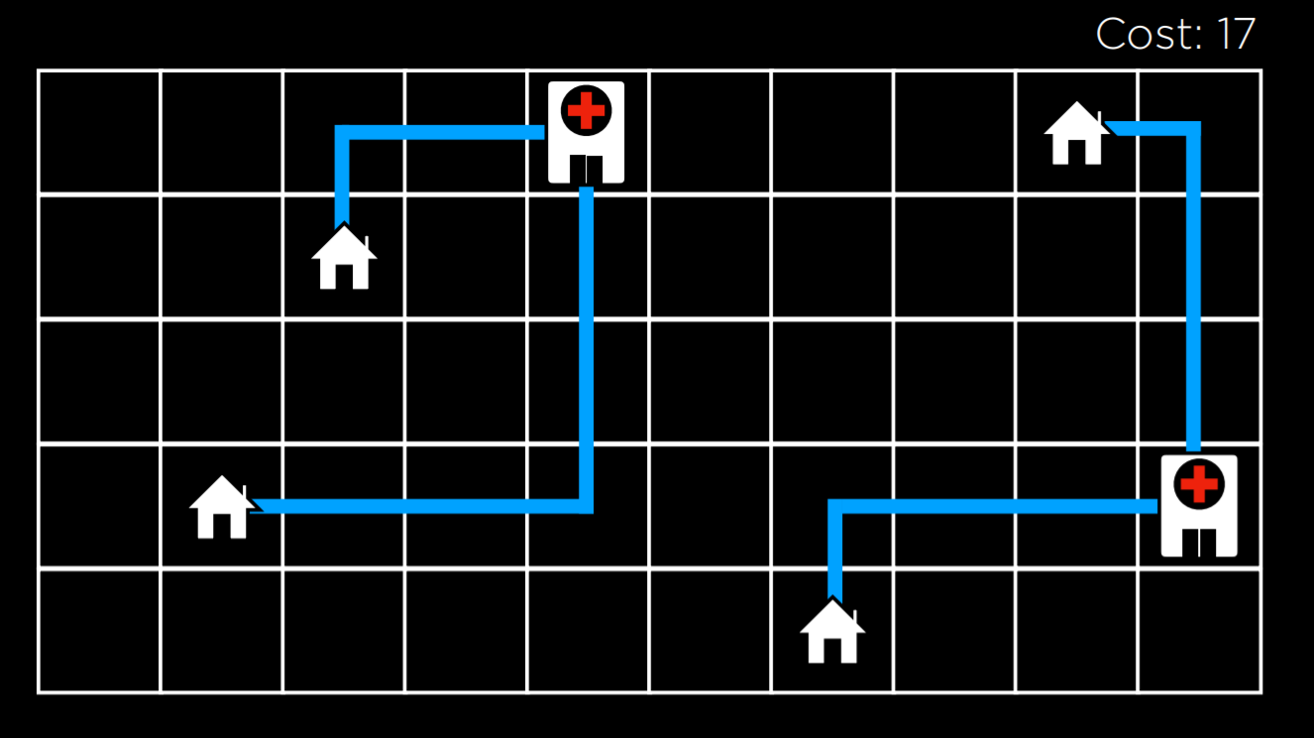
Na obrázku vidíme jedno možné rozmístění domů a nemocnic. Vzdálenost měříme manhattanskou vzdáleností, tedy počtem přesunů nahoru, dolů a do stran, jak jsme probírali v přednášce 0. Součet vzdáleností od každého domu k nejbližší nemocnici je 17. Nazýváme jej náklad, protože tuto vzdálenost chceme minimalizovat. Stav zde představuje kterékoli jednotlivé rozmístění domů a nemocnic.
Pokud tuto představu zobecníme, lze každé rozmístění domů a nemocnic představit pomocí následující krajiny stavového prostoru. Každý sloupec vyjadřuje hodnotu stavu, v našem příkladu náklad daného rozmístění.
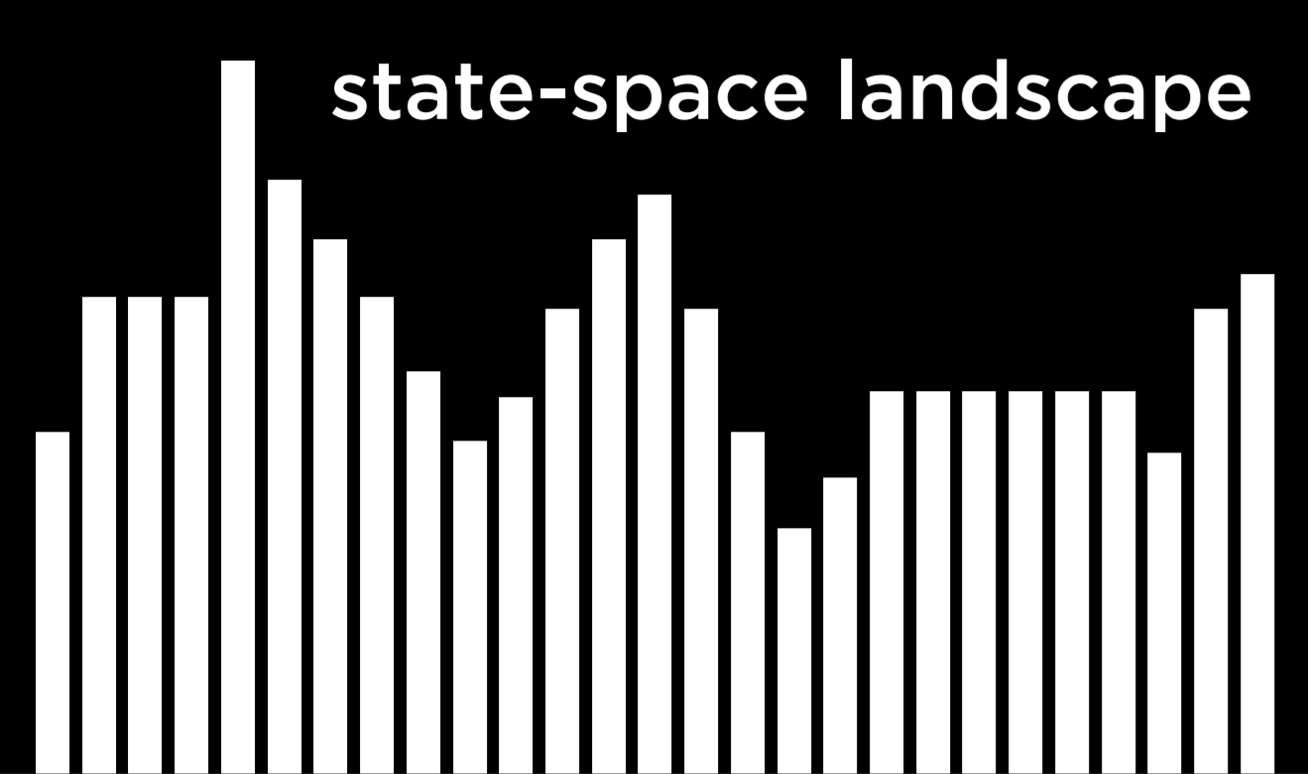
Na základě této vizualizace můžeme zavést několik pojmů pro další výklad:
- Účelová funkce je funkce, kterou používáme k maximalizaci hodnoty řešení.
- Nákladová funkce je funkce, kterou používáme k minimalizaci nákladu řešení. Takovou funkci používáme v příkladu domů a nemocnic, kde chceme minimalizovat vzdálenost domů k nemocnicím.
- Aktuální stav je stav, který funkce právě posuzuje.
- Sousední stav je stav, do něhož může aktuální stav přejít. V jednorozměrné krajině stavového prostoru výše je to stav po jedné nebo druhé straně aktuálního stavu. V našem příkladu může sousední stav vzniknout posunutím jedné nemocnice o jeden krok libovolným směrem. Sousední stavy bývají podobné aktuálnímu stavu, a proto mají obvykle i blízké hodnoty.
Lokální prohledávání tedy posuzuje jeden uzel v aktuálním stavu a poté se přesune do některého z jeho sousedů. Liší se tím například od algoritmu minimax, kde jsme rekurzivně uvažovali každý jednotlivý stav ve stavovém prostoru.
Hill climbing — výstup do kopce
Hill climbing je druh lokálního prohledávání. Algoritmus porovná sousední stavy s aktuálním stavem; pokud je některý lepší, změní aktuální uzel na tento sousední stav. Co znamená „lepší“, závisí na funkci: u účelové funkce upřednostňujeme vyšší hodnotu, u funkce, kterou minimalizujeme, nižší hodnotu.
Pseudokód algoritmu hill climbing vypadá takto:
funkce Hill-Climb(problem):
- current = počáteční stav problému problem
- opakuj:
- neighbor = soused stavu current s nejlepší hodnotou
- pokud neighbor není lepší než current:
- vrať current
- current = neighbor
Začínáme aktuálním stavem. U některých problémů jej známe, u jiných musíme zvolit náhodný počáteční stav. Potom opakovaně vyhodnocujeme sousedy a vybíráme souseda s nejlepší hodnotou. Jeho hodnotu porovnáme s aktuálním stavem. Pokud je soused lepší, přejdeme do něj a celý postup zopakujeme. Proces skončí, když porovnáme nejlepšího souseda s aktuálním stavem a aktuální stav je lepší. Pak aktuální stav vrátíme.
Pomocí algoritmu hill climbing můžeme začít zlepšovat umístění nemocnic v našem příkladu. Po několika přechodech dospějeme k tomuto stavu:
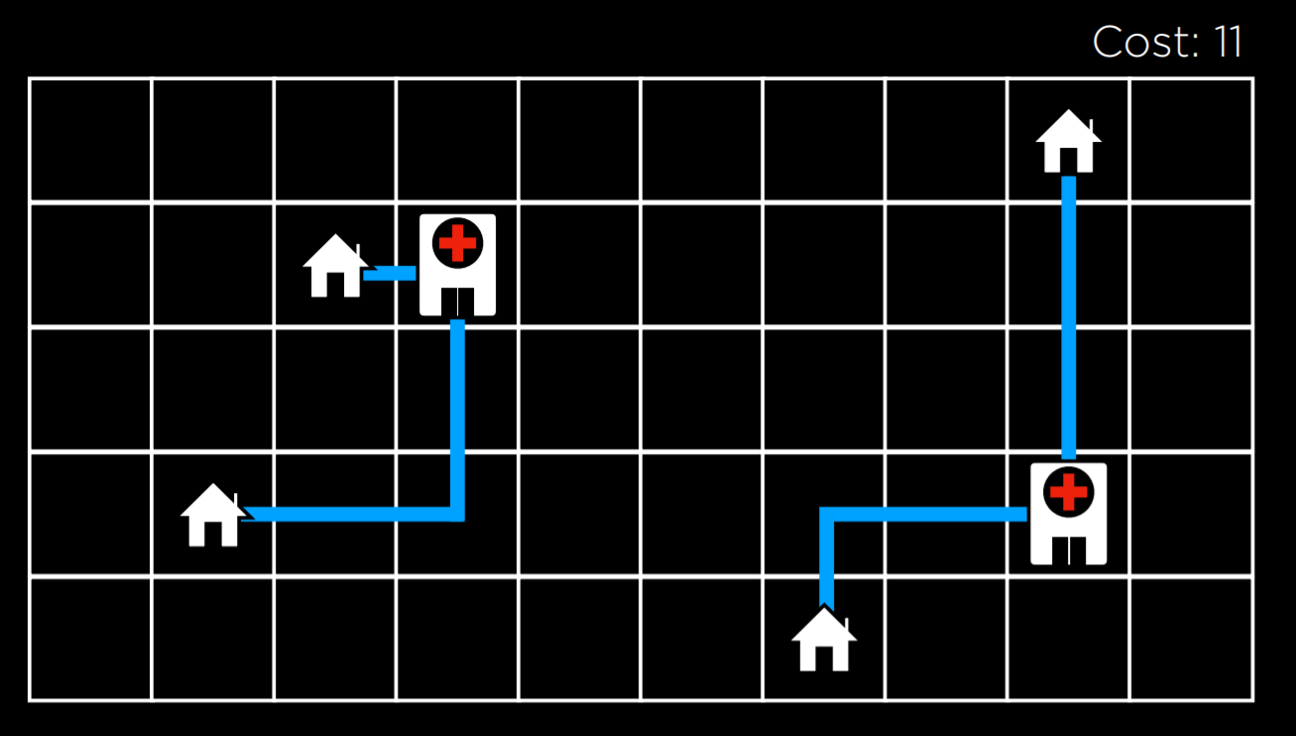
Náklad tohoto stavu je 11, což je zlepšení oproti původním 17. Stále však nejde o optimální stav. Posunutím levé nemocnice pod levý horní dům by například náklad klesl na 9. Tato varianta hill climbing se tam ale nedostane, protože všichni sousedé aktuálního stavu mají alespoň stejně vysoký náklad. Algoritmus je v tomto smyslu krátkozraký: často se spokojí s řešením, které je lepší než některá jiná, ale nemusí být nejlepší ze všech možných řešení.
Lokální a globální minima a maxima
Jak jsme uvedli, hill climbing může uvíznout v lokálním maximu či minimu. Lokální maximum je stav s vyšší hodnotou než jeho sousední stavy. Globální maximum má naproti tomu nejvyšší hodnotu ze všech stavů ve stavovém prostoru.
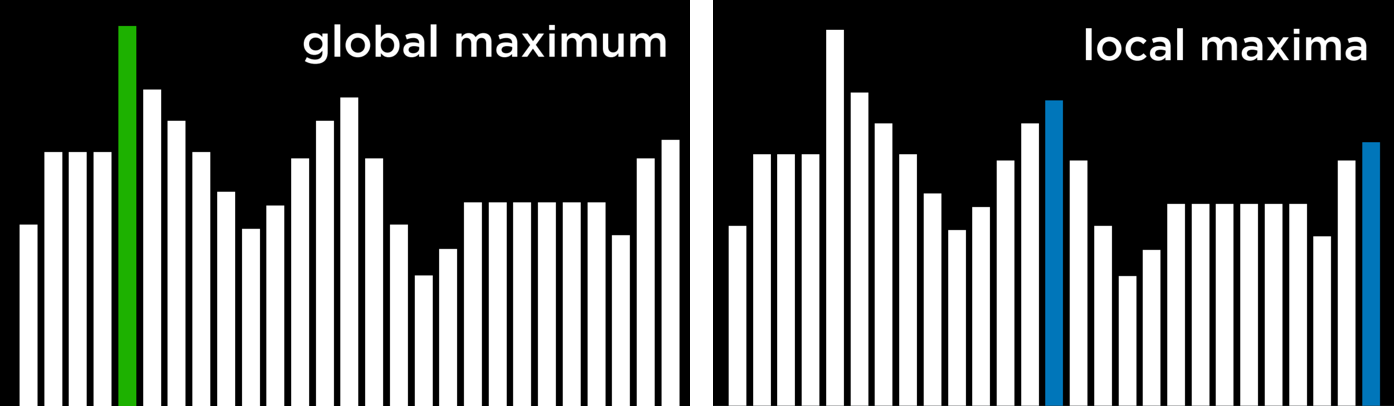
Obdobně je lokální minimum stav s nižší hodnotou než jeho sousední stavy. Globální minimum má nejnižší hodnotu ze všech stavů ve stavovém prostoru.
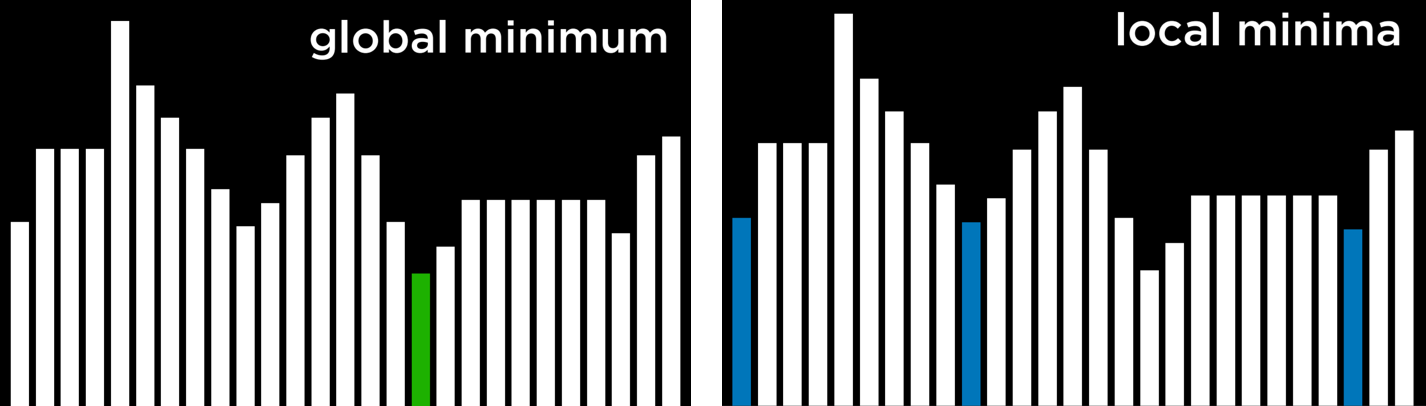
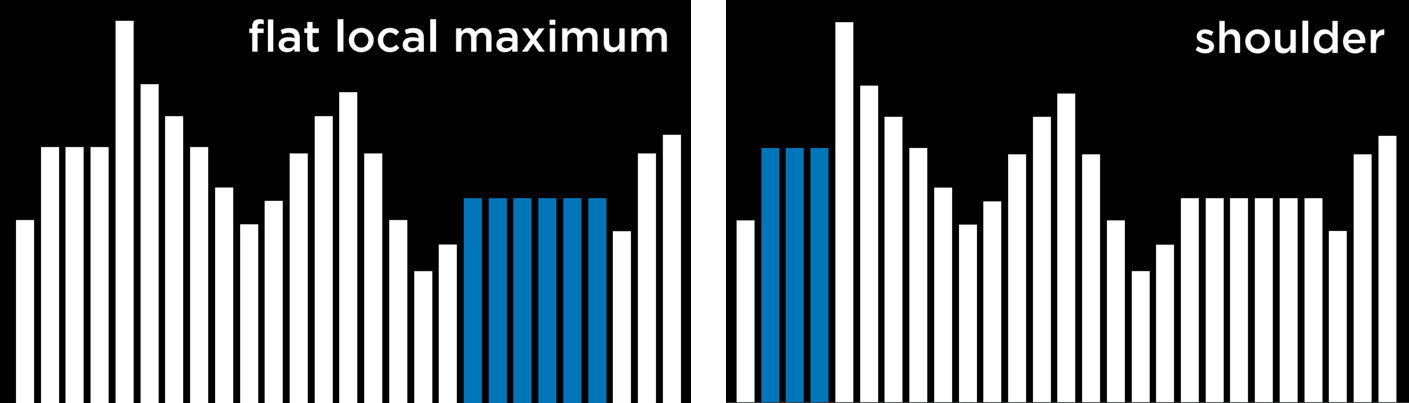
Problém hill climbing spočívá v tom, že může skončit v lokálním minimu či maximu. Jakmile dospěje do bodu, jehož sousedé jsou z hlediska dané funkce horší než aktuální stav, zastaví se. Zvláštními případy jsou ploché lokální maximum/minimum, kde několik sousedících stavů se stejnou hodnotou vytváří plošinu s horšími sousedy, a rameno, kde sousedé takové plošiny mohou být lepší i horší. Z prostředku plošiny se algoritmus nedokáže posunout žádným směrem.
Varianty hill climbing
Kvůli omezením hill climbing vzniklo několik variant, které se snaží překonat uvíznutí v lokálních minimech a maximech. Všechny však mají společné to, že bez ohledu na strategii mohou v lokálním minimu či maximu skončit a nedokážou dále optimalizovat. Následující algoritmy jsou popsány pro případ, kdy vyšší hodnota znamená lepší řešení, ale platí i pro nákladové funkce, jejichž hodnotu chceme minimalizovat.
- Steepest-ascent — nejstrmější výstup: vyber souseda s nejvyšší hodnotou. To je standardní varianta, kterou jsme právě probírali.
- Stochastická varianta: náhodně vybírej mezi sousedy s vyšší hodnotou. Můžeme tak pokračovat libovolným směrem, který hodnotu zlepšuje. To dává smysl například tehdy, když nejlepší soused vede k lokálnímu maximu, zatímco jiný soused by vedl ke globálnímu maximu.
- First-choice — první volba: vyber prvního souseda s vyšší hodnotou.
- Random-restart — náhodný restart: spusť hill climbing vícekrát, pokaždé z náhodného počátečního stavu. Porovnej maxima z jednotlivých běhů a vyber nejvyšší.
- Lokální paprskové prohledávání: vybírá k sousedů s nejvyšší hodnotou. Na rozdíl od většiny algoritmů lokálního prohledávání tedy pracuje s více uzly, nikoli pouze s jedním.
Lokální prohledávání sice nemusí najít nejlepší možné řešení, ale často nalezne dostatečně dobré řešení v situacích, kde by posouzení všech stavů bylo výpočetně neproveditelné.
Simulované žíhání
Viděli jsme varianty, které hill climbing zlepšují, ale všechny sdílejí stejné omezení: po dosažení lokálního maxima se zastaví. Simulované žíhání umožňuje algoritmu z lokálního maxima uniknout.
Žíhání je proces zahřátí kovu a jeho pomalého ochlazování, kterým se upravují jeho vlastnosti. U simulovaného žíhání jde o metaforu: algoritmus začíná při vysoké teplotě, kdy častěji rozhoduje náhodně. S klesající teplotou náhodná rozhodnutí ubývají a algoritmus se stává „pevnějším“. Tento mechanismus mu umožňuje přejít i do sousedního stavu horšího než aktuální stav, a tak uniknout z lokálních maxim. Pseudokód simulovaného žíhání následuje:
funkce Simulated-Annealing(problem, max):
- current = počáteční stav problému problem
- pro t = 1 až max:
- T = Temperature(t)
- neighbor = náhodný soused stavu current
- ΔE = o kolik je neighbor lepší než current
- pokud ΔE > 0:
- current = neighbor
- s pravděpodobností e^(ΔE/T) nastav current = neighbor
- vrať current
Vstupem algoritmu je problém a max, počet opakování. V každé iteraci funkce Temperature určí T: v raných iteracích, kdy je t malé, vrací vyšší hodnotu; v pozdějších nižší. Pak vybereme náhodného souseda a vypočteme ΔE, které vyjadřuje, o kolik je sousední stav lepší než aktuální. Je-li soused lepší (ΔE > 0), přejdeme do něj jako dříve. Je-li horší (ΔE < 0), můžeme do něj přesto přejít, a to s pravděpodobností e^(ΔE/T). Čím zápornější je ΔE, tím menší je pravděpodobnost výběru souseda; čím vyšší je teplota T, tím větší je tato pravděpodobnost. Horší stav má tedy menší šanci na výběr a na začátku běhu algoritmus spíše přijme zhoršení než později. Matematicky: e je konstanta přibližně 2,72 a ΔE je záporné, protože soused je horší. Čím zápornější ΔE, tím více se výsledná hodnota blíží nule. S rostoucím T se ΔE/T blíží nule, takže pravděpodobnost se blíží jedné.
Problém obchodního cestujícího
Úkolem je propojit všechny body tak, aby celková vzdálenost byla co nejkratší. Právě to například potřebují doručovací firmy: najít nejkratší trasu z obchodu ke všem zákazníkům a zpět.
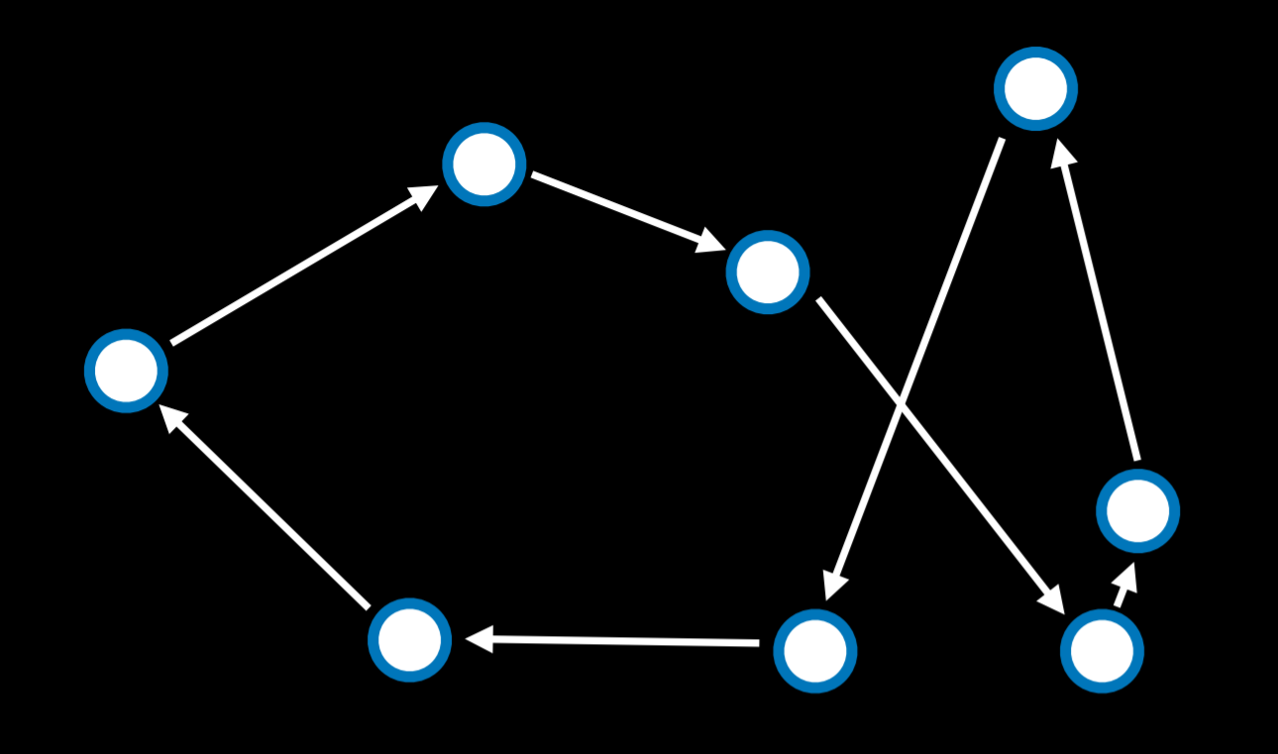
Sousední stav zde může vzniknout prohozením dvou šipek. Výpočet všech kombinací je náročný: už 10 bodů dává 10!, tedy 3 628 800 možných tras. Pomocí simulovaného žíhání lze najít dobré řešení s nižšími výpočetními náklady.
Lineární programování
Lineární programování je rodina problémů optimalizujících lineární rovnici, tedy rovnici tvaru y = ax₁ + bx₂ + ….
Lineární programování má tyto součásti:
- Nákladovou funkci, kterou chceme minimalizovat: c₁x₁ + c₂x₂ + … + cₙxₙ. Každé x₋ je proměnná, se kterou je spojen určitý náklad c₋.
- Omezení vyjádřené součtem proměnných, který je menší nebo roven hodnotě (a₁x₁ + a₂x₂ + … + aₙxₙ ≤ b), případně se jí přesně rovná (a₁x₁ + a₂x₂ + … + aₙxₙ = b). Zde x₋ označuje proměnnou, a₋ příslušný zdroj a b množství zdrojů, které můžeme problému věnovat.
- Samostatné meze proměnných, například zákaz záporných hodnot, ve tvaru lᵢ ≤ xᵢ ≤ uᵢ.
Uvažujme tento příklad:
- Máme dva stroje, X₁ a X₂. Provoz X₁ stojí 50 dolarů za hodinu a X₂ 80 dolarů za hodinu. Cílem je minimalizovat náklady. Nákladovou funkcí je 50x₁ + 80x₂.
- X₁ potřebuje 5 jednotek práce za hodinu a X₂ 2 jednotky. Celkem máme 20 jednotek práce. Omezení tedy zní 5x₁ + 2x₂ ≤ 20.
- X₁ vyrobí 10 jednotek výstupu za hodinu a X₂ 12 jednotek. Firma potřebuje 90 jednotek výstupu. To je další omezení, které lze zapsat 10x₁ + 12x₂ ≥ 90. Omezení však potřebujeme ve tvaru (a₁x₁ + a₂x₂ + … + aₙxₙ ≤ b) nebo (a₁x₁ + a₂x₂ + … + aₙxₙ = b). Vynásobíme proto výraz číslem −1 a dostaneme ekvivalentní rovnici požadovaného tvaru: (−10x₁) + (−12x₂) ≤ −90.
Optimalizační algoritmus pro lineární programování vyžaduje znalosti geometrie a lineární algebry, které zde nechceme předpokládat. Místo toho můžeme využít hotové algoritmy, například Simplex či metody vnitřního bodu.
Následuje příklad lineárního programování s knihovnou scipy v Pythonu:
import scipy.optimize

# Objective Function: 50x_1 + 80x_2
# Constraint 1: 5x_1 + 2x_2 <= 20
# Constraint 2: -10x_1 + -12x_2 <= -90

result = scipy.optimize.linprog(
    [50, 80],  # Cost function: 50x_1 + 80x_2
    A_ub=[[5, 2], [-10, -12]],  # Coefficients for inequalities
    b_ub=[20, -90],  # Constraints for inequalities: 20 and -90
)

if result.success:
    print(f"X1: {round(result.x[0], 2)} hours")
    print(f"X2: {round(result.x[1], 2)} hours")
else:
    print("No solution")
Splňování omezujících podmínek
Úlohy splňování omezujících podmínek jsou problémy, v nichž musíme proměnným přiřadit hodnoty tak, aby platily určité podmínky.
Takové úlohy mají tyto součásti:
- Množinu proměnných (x₁, x₂, …, xₙ).
- Množinu domén jednotlivých proměnných {D₁, D₂, …, Dₙ}.
- Množinu omezení C.
Sudoku lze vyjádřit jako úlohu splňování podmínek: každé prázdné políčko je proměnná, její doménou jsou čísla 1–9 a omezení určují, která políčka nesmějí mít stejnou hodnotu.
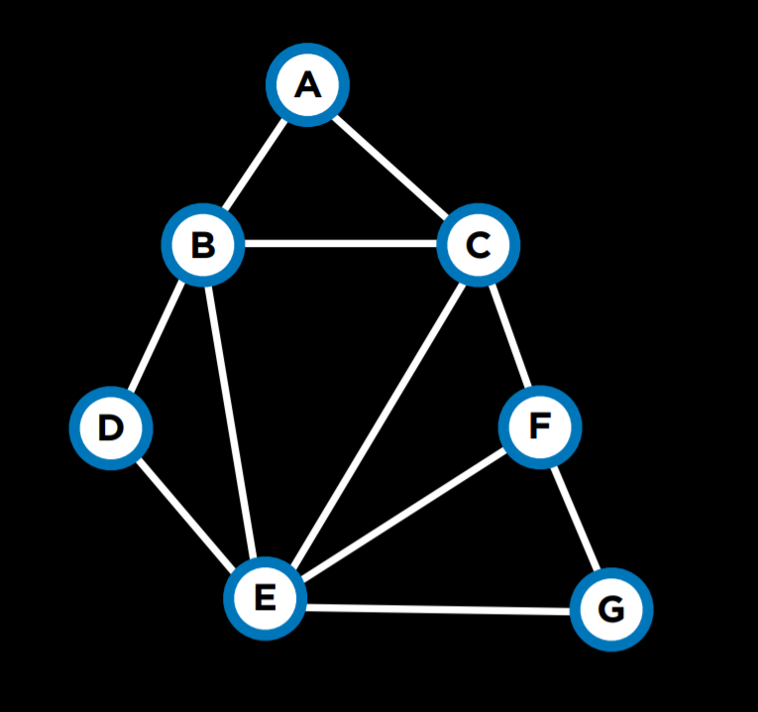
Uvažujme další příklad. Každý ze studentů 1–4 studuje tři předměty z množiny A, B, …, G. Každý předmět musí mít zkoušku a možné termíny jsou pondělí, úterý a středa. Jeden student ale nemůže mít ve stejný den dvě zkoušky. Proměnnými jsou předměty, doménou dny a omezení určují, které předměty nesmějí mít zkoušku ve stejný den, protože je studuje tentýž student. Problém lze znázornit takto:

Problém lze řešit pomocí omezení reprezentovaných grafem. Každý uzel je předmět; hrana propojuje dva předměty, jejichž zkoušky nelze naplánovat na stejný den. Graf tedy vypadá takto:
Další pojmy pro úlohy splňování podmínek:
- Tvrdé omezení musí být ve správném řešení splněno.
- Měkké omezení vyjadřuje, kterému řešení dáváme přednost před jiným.
- Unární omezení zahrnuje jedinou proměnnou. V našem příkladu by jím byl požadavek, že předmět A nesmí mít zkoušku v pondělí {A ≠ Monday}.
- Binární omezení zahrnuje dvě proměnné. Takové omezení jsme používali výše, když jsme požadovali různé hodnoty dvou předmětů {A ≠ B}.
Uzlová konzistence
Uzlová konzistence nastává, když všechny hodnoty v doméně proměnné splňují její unární omezení.
Uvažujme předměty A a B. Doménou obou je {Monday, Tuesday, Wednesday}, tedy pondělí, úterý a středa, a omezení jsou {A ≠ Mon, B ≠ Tue, B ≠ Mon, A ≠ B}. A ani B nyní nejsou konzistentní, protože omezení neumožňují přijmout všechny hodnoty jejich domén. Odstraníme-li z domény A pondělí, dosáhneme uzlové konzistence A. Pro uzlovou konzistenci B musíme odstranit pondělí i úterý.
Hranová konzistence
Hranová konzistence nastává, když všechny hodnoty v doméně proměnné splňují její binární omezení. Anglický výraz „arc“ zde znamená to, co jsme dříve nazývali „edge“, tedy hranu. Chceme-li, aby X bylo hranově konzistentní vzhledem k Y, odstraňujeme prvky domény X, dokud pro každou volbu X neexistuje přípustná volba Y.
Vraťme se k příkladu s upravenými doménami A:{Tuesday, Wednesday} a B:{Wednesday}. Aby A bylo hranově konzistentní s B, musí zbýt možný termín zkoušky B bez ohledu na zvolený termín A z jeho domény. Je tomu tak? Pokud A zvolí úterý, B může zvolit středu. Pokud ale A zvolí středu, B nemá žádnou přípustnou hodnotu, protože platí A ≠ B. A tedy není hranově konzistentní s B. Odstraníme z domény A středu. Pak pro libovolnou hodnotu A, tedy nyní pouze úterý, zbývá hodnota B, středa. A je teď hranově konzistentní s B. Následující pseudokód činí proměnnou hranově konzistentní vzhledem k jiné proměnné. Zkratka csp označuje „constraint satisfaction problem“, úlohu splňování podmínek.
funkce Revise(csp, X, Y):
- revised = false
- pro každé x v X.domain:
- pokud žádné y v Y.domain nesplňuje omezení pro (X,Y):
- odstraň x z X.domain
- revised = true
- pokud žádné y v Y.domain nesplňuje omezení pro (X,Y):
- vrať revised
Algoritmus nejprve pomocí proměnné revised sleduje, zda se doména X změnila. To využijeme v dalším algoritmu. Potom projde každou hodnotu v doméně X a ověří, zda v Y existuje hodnota splňující omezení. Pokud ano, nic nezmění; pokud ne, odstraní příslušnou hodnotu z domény X.
Často chceme dosáhnout hranové konzistence celého problému, nikoli pouze jedné proměnné vzhledem k jiné. Použijeme k tomu algoritmus AC-3, který volá Revise:
funkce AC-3(csp):
- queue = všechny hrany v csp
- dokud je queue neprázdná:
- (X, Y) = Dequeue(queue)
- pokud Revise(csp, X, Y):
- pokud je velikost X.domain == 0:
- vrať false
- pro každé Z v X.neighbors − {Y}:
- Enqueue(queue, (Z,X))
- pokud je velikost X.domain == 0:
- vrať true
Algoritmus přidá všechny hrany problému do fronty. Při každém posouzení hranu z fronty odebere a algoritmem Revise zkontroluje její konzistenci. Pokud se doména změnila, jsou potřeba další kroky. Je-li výsledná doména X prázdná, úloha nemá řešení: neexistuje hodnota X, která by při daných omezeních umožnila jakoukoli hodnotu Y. Pokud jsme problém v předchozím kroku neoznačili za neřešitelný, musíme kvůli změně domény X prověřit i ostatní hrany související s X. Vezmeme tedy všechny sousedy X kromě Y a přidáme příslušné hrany zpět do fronty. Vrátí-li Revise false, doména se nezměnila a pokračujeme dalšími hranami.
Algoritmus hranové konzistence může problém zjednodušit, ale nemusí jej vyřešit: zohledňuje pouze binární omezení, nikoli všechny souvislosti mezi více uzly. Náš předchozí příklad, kde každý ze čtyř studentů studuje tři předměty, se po spuštění AC-3 nezmění.
S vyhledávacími úlohami jsme se setkali v první přednášce. I úlohu splňování podmínek můžeme chápat jako vyhledávání:
- Počáteční stav: prázdné přiřazení, žádná proměnná nemá hodnotu.
- Akce: přidat do přiřazení {variable = value}, tedy přiřadit proměnné hodnotu.
- Přechodový model: ukazuje změnu přiřazení po přidání hodnoty. Zde je jednoduchý: vrátí stav obsahující přiřazení po poslední akci.
- Test cíle: ověřit, zda všechny proměnné mají hodnotu a všechna omezení jsou splněna.
- Nákladová funkce cesty: všechny cesty mají stejný náklad. Jak jsme uvedli, optimalizační úlohy se na rozdíl od běžného vyhledávání zajímají o výsledné řešení, nikoli o cestu k němu.
Naivní řešení úlohy splňování podmínek jako běžného vyhledávání je však velmi neefektivní. Využijeme proto její strukturu a nalezneme efektivnější postup.
Prohledávání se zpětným návratem
Backtracking neboli prohledávání se zpětným návratem zohledňuje strukturu úlohy splňování podmínek. Obvykle jde o rekurzivní funkci, která pokračuje v přiřazování hodnot, dokud jsou splněna omezení. Při porušení omezení zkusí jiné přiřazení. Podívejme se na pseudokód:
funkce Backtrack(assignment, csp):
- pokud je assignment úplné:
- vrať assignment
- var = Select-Unassigned-Var(assignment, csp)
- pro každé value v Domain-Values(var, assignment, csp):
- pokud je value konzistentní s assignment:
- přidej {var = value} do assignment
- result = Backtrack(assignment, csp)
- pokud result ≠ failure:
- vrať result
- odstraň {var = value} z assignment
- pokud je value konzistentní s assignment:
- vrať failure
Algoritmus nejprve vrátí aktuální přiřazení, je-li úplné. Pokud tedy práci dokončil, neprovádí další akce a vrací výsledek. Není-li přiřazení úplné, zvolí některou proměnnou bez hodnoty. Zkusí jí přiřadit hodnotu a znovu spustí Backtrack s tímto přiřazením, tedy rekurzivně. Pak ověří výsledek. Pokud není failure, přiřazení fungovalo a má být vráceno. Pokud je failure, poslední přiřazení odstraní a stejným postupem vyzkouší další hodnotu. Vrátí-li failure všechny hodnoty domény, musíme se vrátit o krok zpět: problém vznikl u některého předchozího přiřazení. Stane-li se to už u počáteční proměnné, žádné řešení nesplňuje omezení.
Uvažujme následující postup:
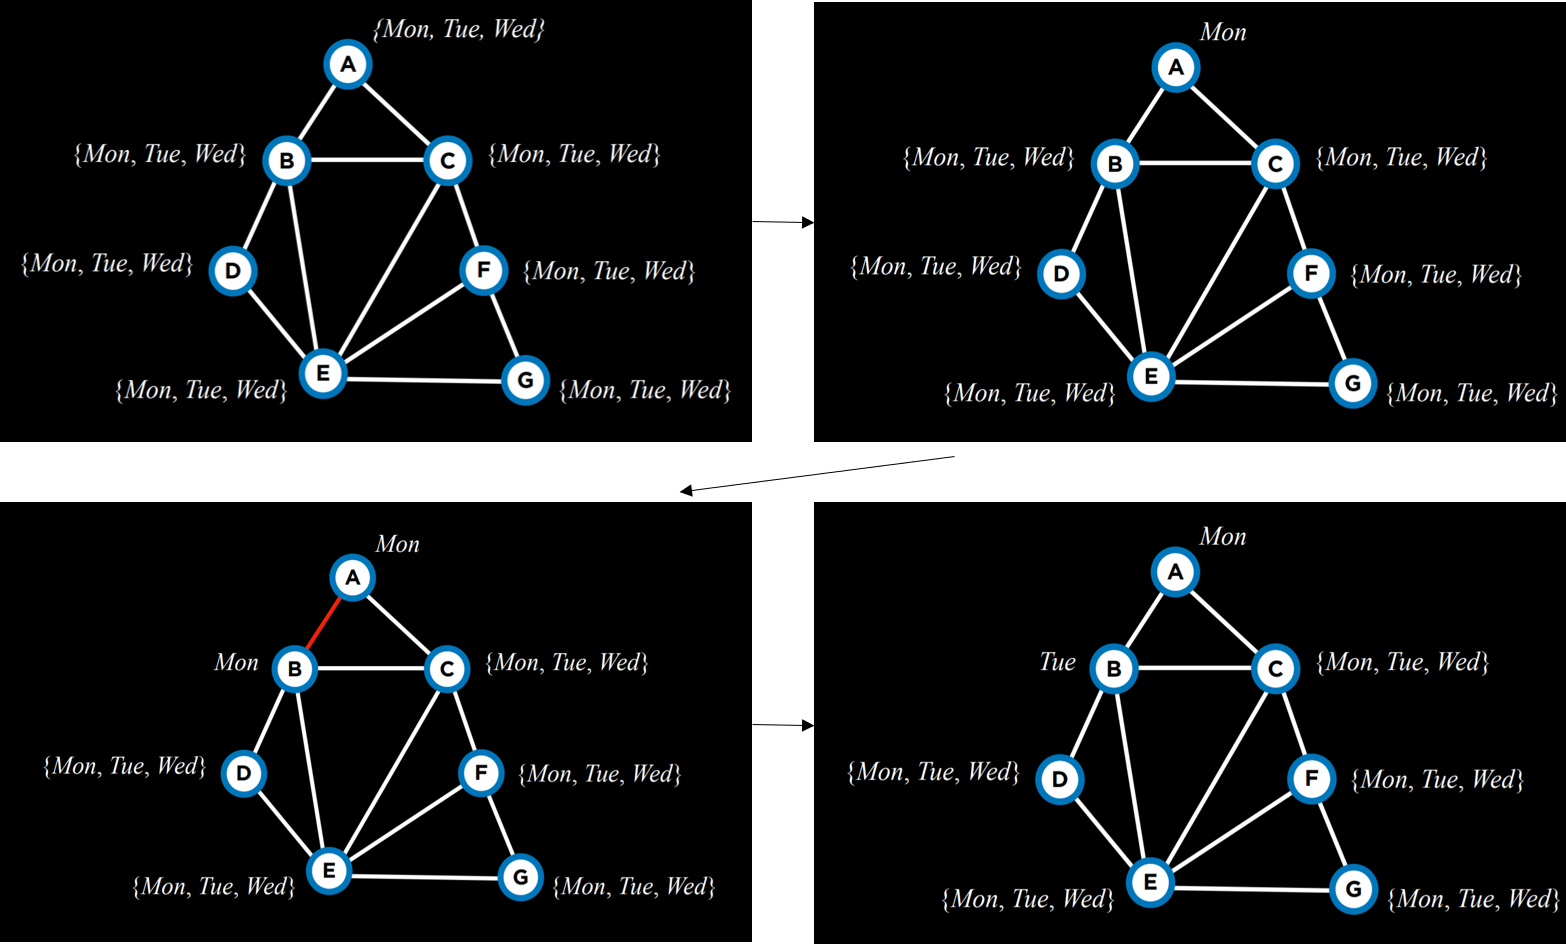
Začínáme prázdným přiřazením vlevo nahoře. Zvolíme A a přiřadíme pondělí, vpravo nahoře. S tímto přiřazením algoritmus spustíme znovu. Protože A už hodnotu má, zvolí B a přiřadí mu pondělí, vlevo dole. Přiřazení vrátí false, takže místo přiřazování C zkusíme novou hodnotu B, úterý, vpravo dole. Toto přiřazení podmínky splňuje a pokračujeme další proměnnou. Pokud by ale i úterý a středa u B vedly k neúspěchu, algoritmus by se vrátil k A a zkusil další hodnotu, úterý. Pokud by i úterý a středa vrátily failure, vyzkoušeli jsme všechna přiřazení a problém je neřešitelný.
V části se zdrojovým kódem najdeš implementaci backtrackingu od základů. Algoritmus je však rozšířený, takže jej obsahuje i řada hotových knihoven.
Odvozování
Backtracking je efektivnější než prosté prohledávání, přesto potřebuje mnoho výpočetních prostředků. Prosazování hranové konzistence je méně náročné. Prokládáním backtrackingu a odvozování, tedy prosazování hranové konzistence, můžeme získat efektivnější algoritmus zvaný Maintaining Arc-Consistency — udržování hranové konzistence. Prosadí hranovou konzistenci po každém novém přiřazení. Konkrétně: po přiřazení X zavoláme AC-3 s frontou všech hran (Y,X), kde Y je soused X, nikoli s frontou všech hran problému. Následuje upravený Backtrack, který udržuje hranovou konzistenci; doplněné části jsou tučně.
funkce Backtrack(assignment, csp):
- pokud je assignment úplné:
- vrať assignment
- var = Select-Unassigned-Var(assignment, csp)
- pro každé value v Domain-Values(var, assignment, csp):
- pokud je value konzistentní s assignment:
- přidej {var = value} do assignment
- inferences = Inference(assignment, csp)
- pokud inferences ≠ failure:
- přidej inferences do assignment
- result = Backtrack(assignment, csp)
- pokud result ≠ failure:
- vrať result
- odstraň {var = value} a inferences z assignment
- pokud je value konzistentní s assignment:
- vrať failure
Funkce Inference spustí popsaný algoritmus AC-3. Jejím výstupem jsou všechny závěry, které lze odvodit prosazením hranové konzistence. Jde tedy o nová přiřazení vyplývající z předchozích přiřazení a ze struktury úlohy splňování podmínek.
Algoritmus lze dále zefektivnit. Dosud jsme nepřiřazenou proměnnou volili náhodně. Některé volby však s větší pravděpodobností vedou k řešení rychleji než jiné. K tomu slouží heuristiky: praktická pravidla, která častěji přinesou lepší výsledek než naivní postup, ale nemají tuto vlastnost zaručenou.
Jednou z nich je Minimum Remaining Values (MRV) — nejméně zbývajících hodnot. Pokud odvozování zúžilo doménu proměnné na jedinou hodnotu, případně dvě, jejím přiřazením můžeme omezit pozdější zpětné návraty. Toto přiřazení totiž stejně dříve či později musíme provést, protože vyplývá z hranové konzistence. Pokud vede k neúspěchu, je lepší to zjistit co nejdříve a nevracet se později.
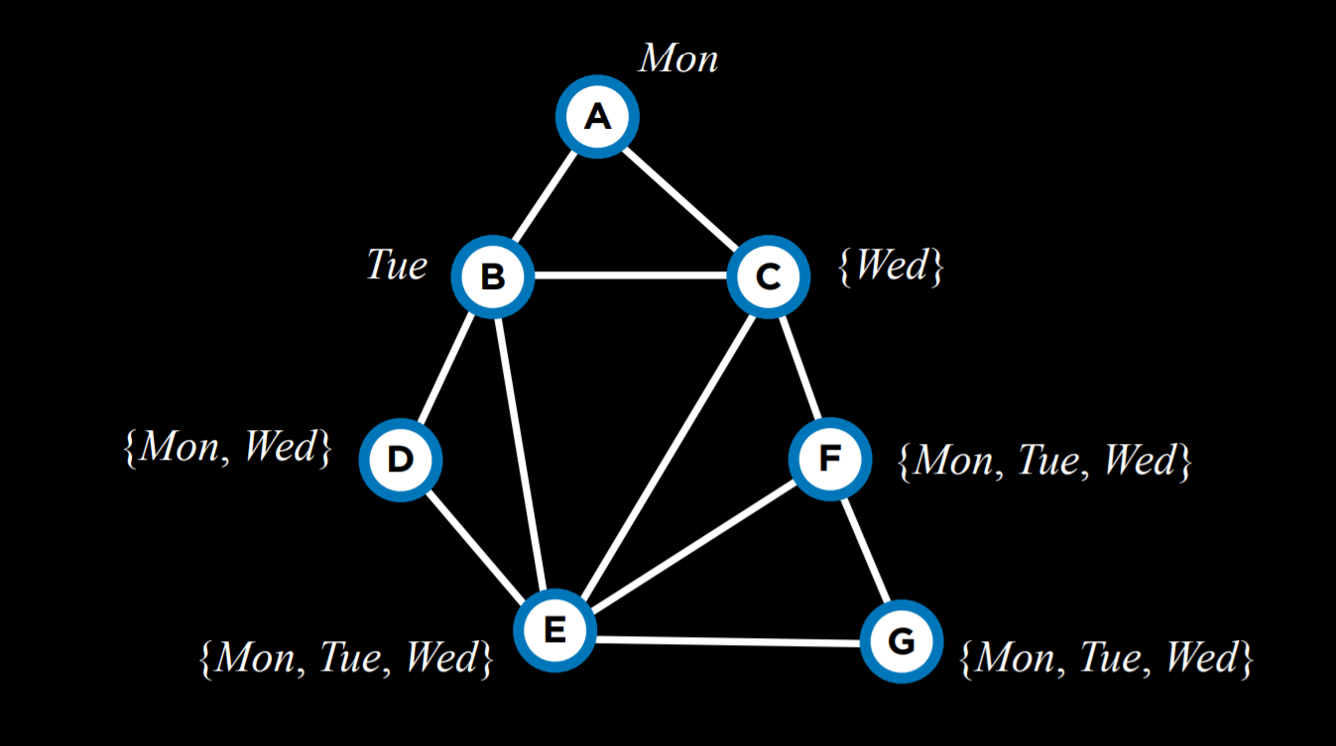
Po zúžení domén na základě aktuálního přiřazení tedy pomocí MRV vybereme jako další proměnnou C a přiřadíme jí středu.
Heuristika stupně vychází ze stupně proměnné, tedy z počtu hran, kterými je spojena s ostatními. Výběrem proměnné s nejvyšším stupněm omezíme jediným přiřazením více dalších proměnných a zrychlíme postup algoritmu.
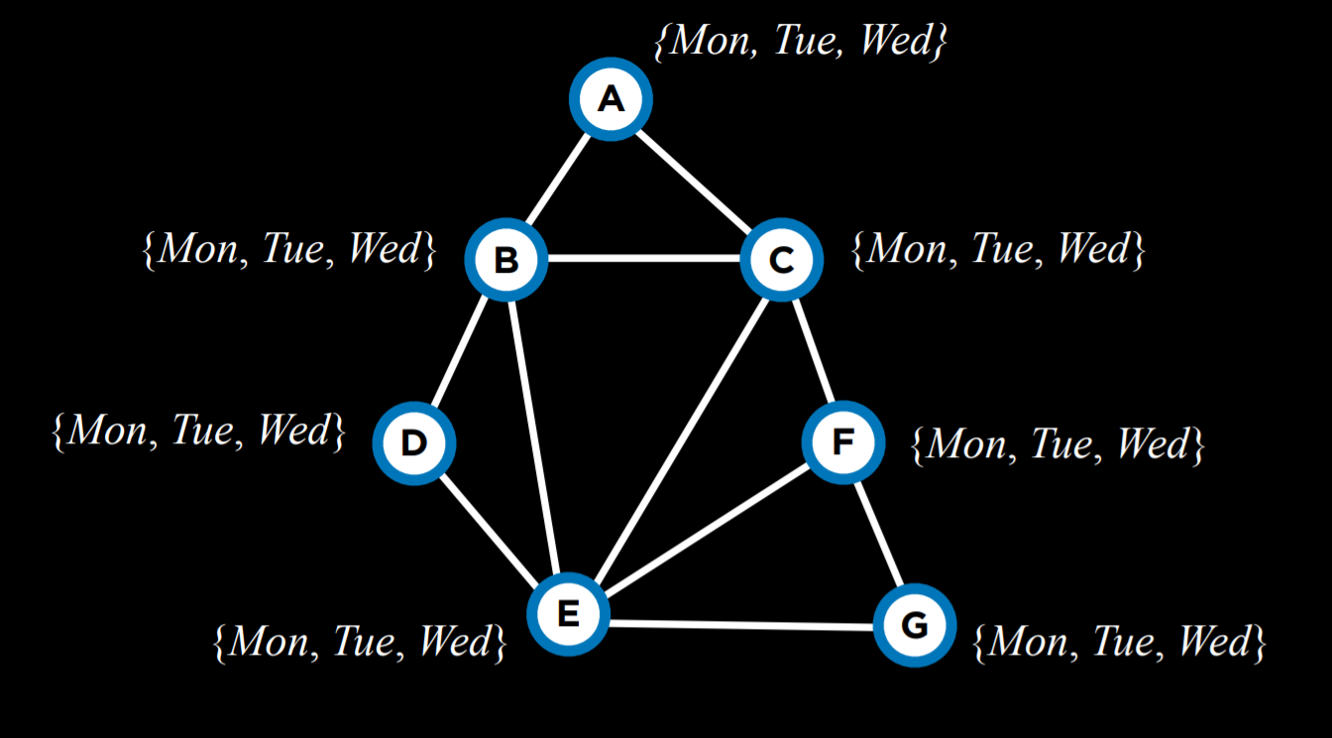
V příkladu výše mají všechny proměnné stejně velké domény. Vybereme tedy tu s nejvyšším stupněm, proměnnou E.
Obě heuristiky někdy nedokážou rozhodnout: například pokud má více proměnných stejný nejmenší počet hodnot v doméně nebo stejný nejvyšší stupeň.
Další heuristika zefektivňuje volbu hodnoty z domény proměnné: Least Constraining Values — nejméně omezující hodnoty. Vybereme hodnotu, která omezí nejméně dalších proměnných. Zatímco heuristika stupně volila proměnnou schopnou omezit co nejvíce dalších proměnných, zde chceme, aby jim její hodnota ponechala co největší volnost. Vyhledáme tedy možný největší zdroj problémů, proměnnou s nejvyšším stupněm, a vhodnou hodnotou omezíme jeho problematičnost.
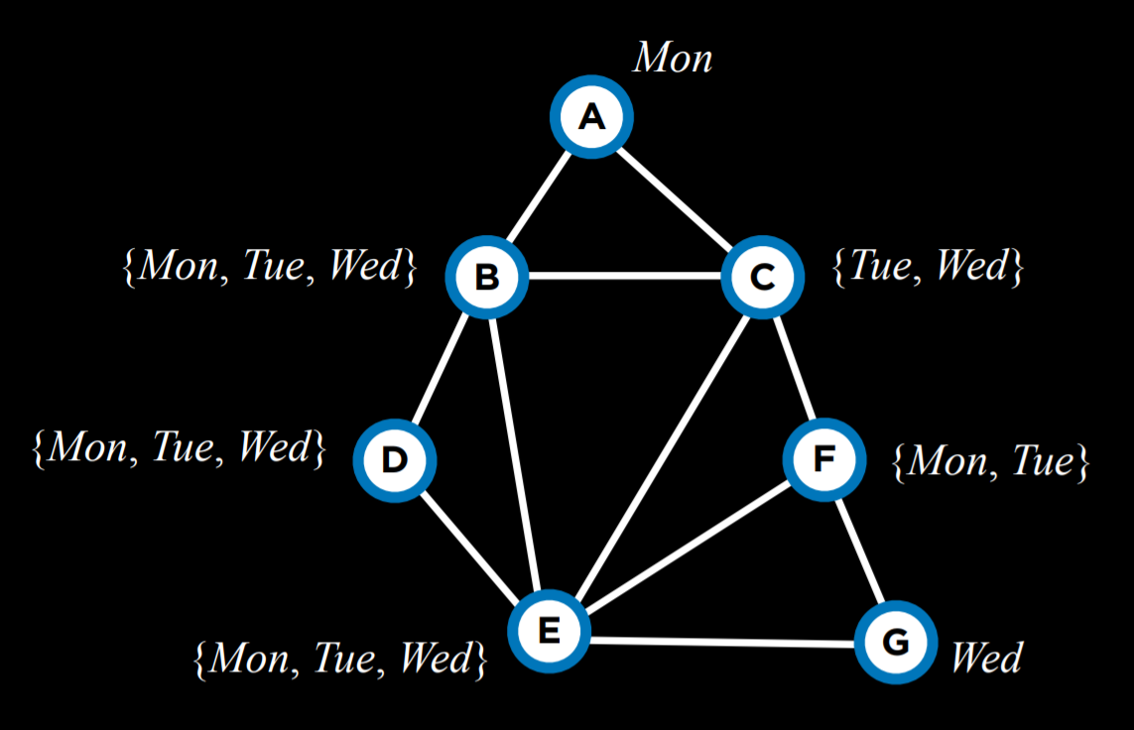
Uvažujme C. Přiřadíme-li jí úterý, omezíme B, E i F. Přiřadíme-li středu, omezíme pouze B a E. Proto je pravděpodobně lepší zvolit středu.
Optimalizační problémy tedy můžeme formulovat různými způsoby. Dnes jsme probírali lokální prohledávání, lineární programování a splňování omezujících podmínek.