Přednáška 2 — Nejistota
Nejistota
V minulé přednášce jsme se zabývali tím, jak AI reprezentuje znalosti a odvozuje nové. Ve skutečnosti však často zná svět jen částečně, takže vzniká prostor pro nejistotu. Přesto chceme, aby se i v takových situacích rozhodovala co nejlépe. Například při předpovědi počasí má informace o dnešním počasí, ale zítřejší počasí nemůže předpovědět se stoprocentní přesností. Můžeme však být úspěšnější než při náhodném odhadu. Dnešní přednáška ukazuje, jak vytvořit AI, která se při omezených informacích a nejistotě rozhoduje optimálně.
Pravděpodobnost
Nejistotu můžeme reprezentovat pomocí událostí a možnosti jejich výskytu, tedy jejich pravděpodobnosti.
Možné světy
Každou možnou situaci můžeme chápat jako svět, označovaný malým řeckým písmenem omega ω. Hod kostkou má například šest možných světů: v jednom padne 1, v dalším 2 a tak dále. Pravděpodobnost určitého světa zapisujeme P(ω).
Axiomy pravděpodobnosti
- 0 < P(ω) < 1: každá hodnota pravděpodobnosti musí ležet mezi 0 a 1.
- Nula označuje nemožnou událost, například sedmičku na běžné šestistěnné kostce.
- Jednička označuje jistou událost, například hodnotu menší než 10 na běžné kostce.
- Obecně čím vyšší hodnota, tím pravděpodobnější výskyt události.
- Součet pravděpodobností všech možných výsledků je roven 1.
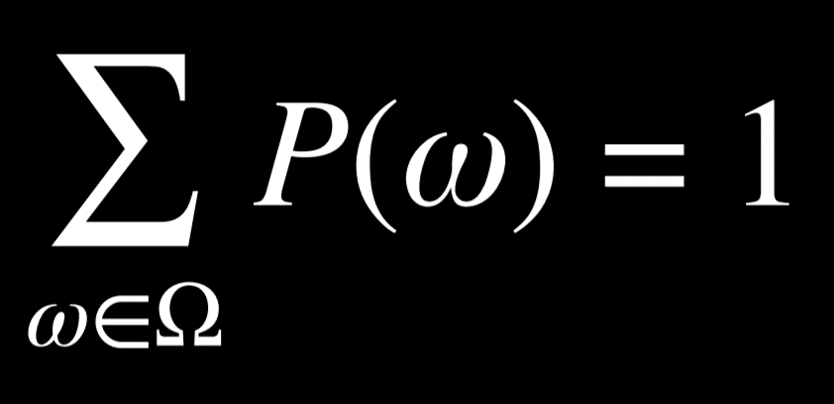
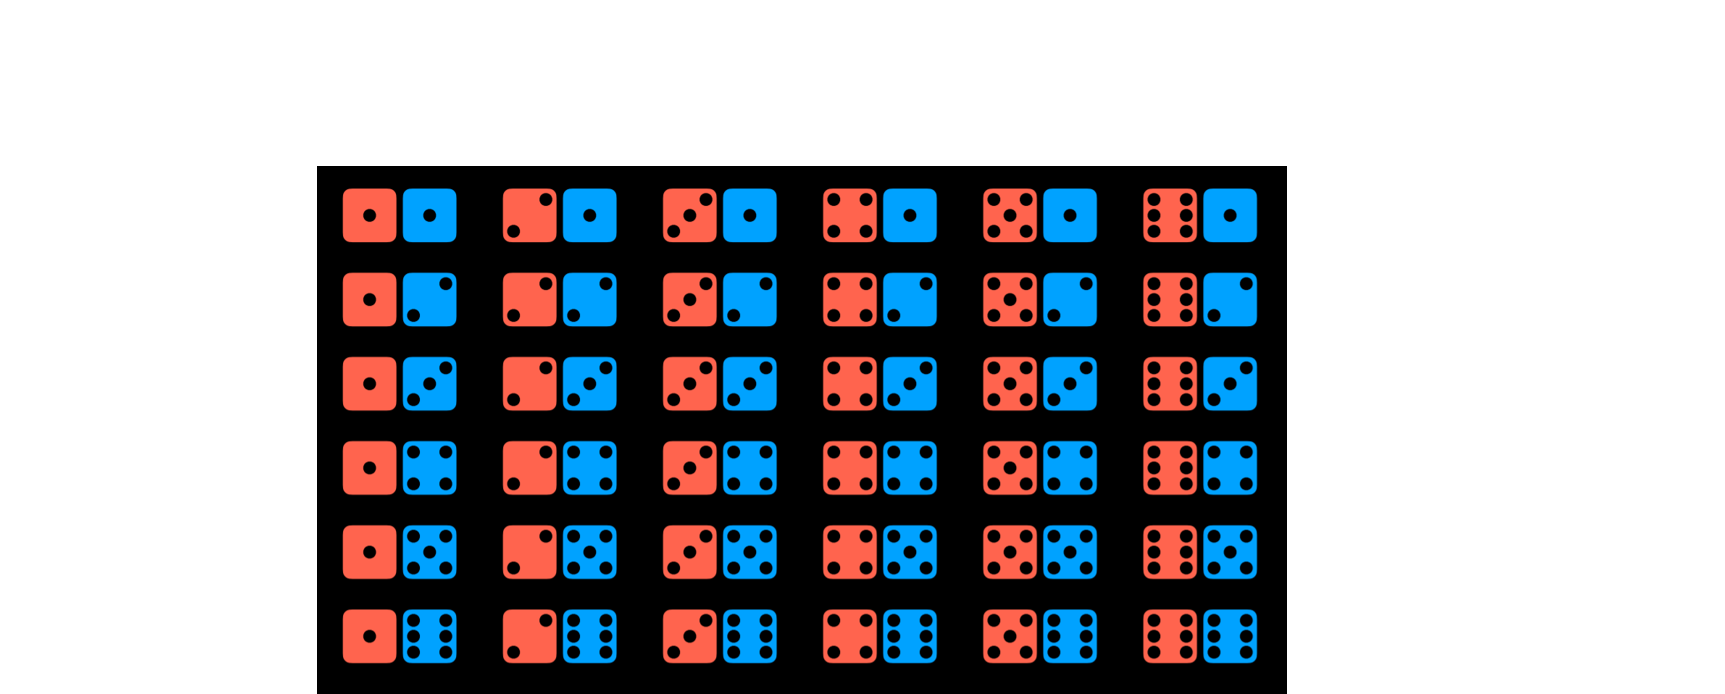
Pravděpodobnost, že na běžné kostce padne číslo R, zapisujeme P(R). Zde P(R) = 1/6, protože máme šest možných světů, tedy výsledky 1 až 6, a každý je stejně pravděpodobný. Uvažujme nyní hod dvěma kostkami: existuje 36 možných výsledků a opět jsou všechny stejně pravděpodobné.
Co však nastane, když chceme předpovědět součet obou kostek? Máme jen 11 možných hodnot, od 2 do 12, a nevyskytují se stejně často.
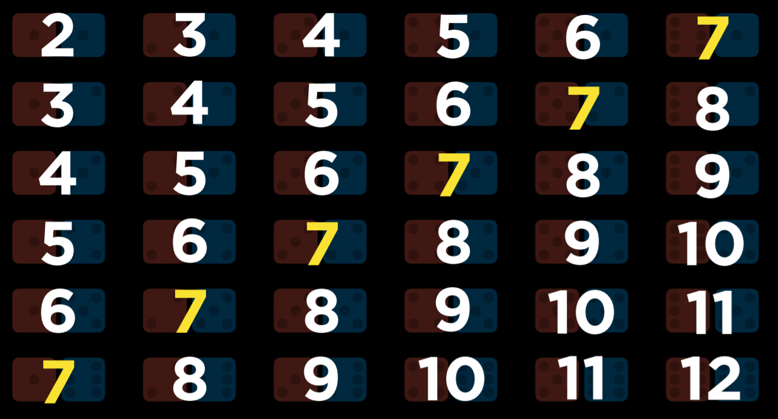
Pravděpodobnost události získáme podílem počtu světů, kde nastává, a celkového počtu možných světů. U dvou kostek existuje 36 světů. Pouze v jednom, kde obě kostky ukazují 6, dostaneme součet 12. Proto P(12) = 1/36. Pravděpodobnost hodu dvěma kostkami se součtem 12 je tedy 1/36. A co P(7)? Spočítáme, že součet 7 nastává v šesti světech, takže P(7) = 6/36 = 1/6.
Nepodmíněná pravděpodobnost
Nepodmíněná pravděpodobnost je míra přesvědčení o výroku bez dalších důkazů. Dosavadní otázky byly nepodmíněné: výsledek hodu kostkou nezávisí na předchozích událostech.
Podmíněná pravděpodobnost
Podmíněná pravděpodobnost je míra přesvědčení o výroku při znalosti již zjištěného důkazu. Jak jsme uvedli v úvodu, AI může využívat částečné informace k informovaným odhadům budoucnosti. Aby mohla využít informace ovlivňující pravděpodobnost budoucí události, používá podmíněnou pravděpodobnost.
Zapisujeme ji P(a | b): „pravděpodobnost události a, pokud víme, že nastala událost b“, stručně „pravděpodobnost a za podmínky b“. Můžeme se například ptát na pravděpodobnost dnešního deště, pokud pršelo včera: P(rain today | rain yesterday); nebo na pravděpodobnost onemocnění pacienta při známém výsledku testu: P(disease | test results).
Matematicky podmíněnou pravděpodobnost a při daném b počítáme tímto vzorcem:
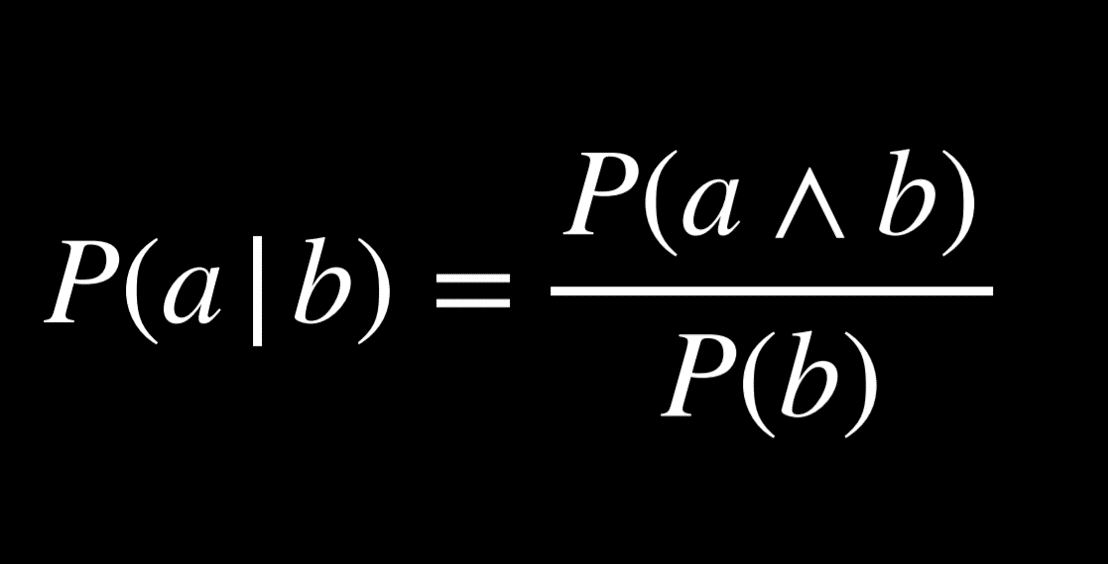
Slovy: pravděpodobnost a za podmínky b se rovná pravděpodobnosti současné pravdivosti a a b dělené pravděpodobností b. Intuitivně nás zajímají události, kde platí a i b, tedy čitatel, ale pouze ve světech, kde už víme, že platí b, tedy jmenovatel. Dělení pravděpodobností b omezuje možné světy na ty, kde b platí. Následující tvary jsou algebraicky ekvivalentní s uvedeným vzorcem:
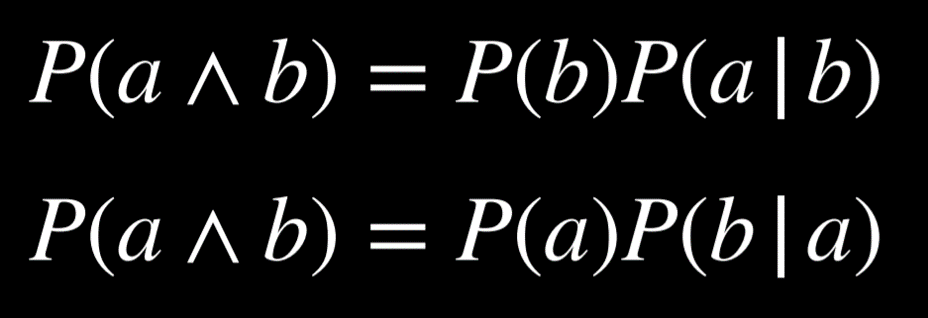
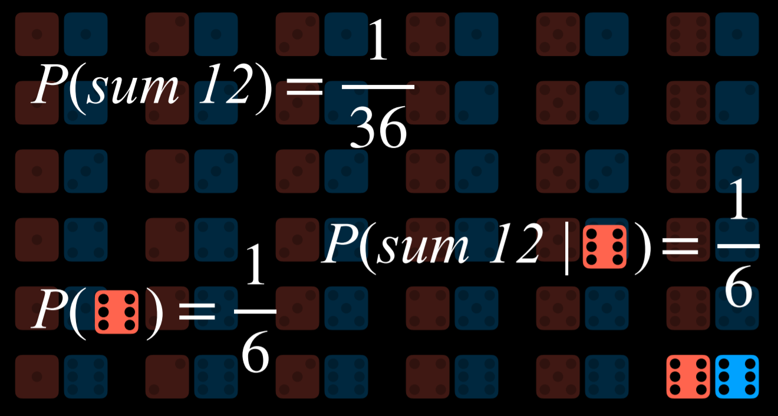
Například P(sum 12 | roll six on one die) je pravděpodobnost součtu 12 na dvou kostkách za podmínky, že jsme první kostkou již hodili 6. Nejprve omezíme možné světy na ty, kde první kostka ukazuje šestku:
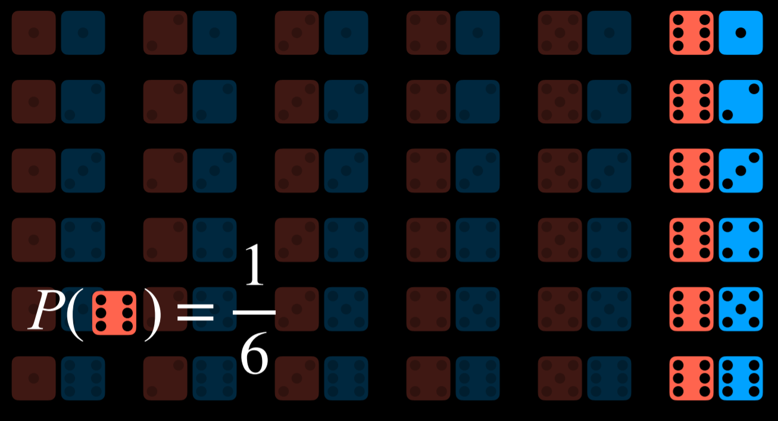
Potom zjišťujeme, kolikrát událost a, tedy součet 12, nastává v takto omezených světech. Dělíme tedy P(b), pravděpodobností šestky na první kostce.
Náhodné veličiny
Náhodná veličina je v teorii pravděpodobnosti veličina s oborem možných hodnot. Výsledky hodu kostkou můžeme reprezentovat veličinou Roll s hodnotami {1, 2, 3, 4, 5, 6}. Stav letu může reprezentovat Flight s hodnotami {on time, delayed, canceled}, tedy včas, zpožděný a zrušený.
Často nás zajímá pravděpodobnost výskytu jednotlivých hodnot. Reprezentujeme ji pravděpodobnostním rozdělením. Například:
- P(Flight = on time) = 0.6
- P(Flight = delayed) = 0.3
- P(Flight = canceled) = 0.1
Slovně toto rozdělení znamená 60% pravděpodobnost letu včas, 30% pravděpodobnost zpoždění a 10% pravděpodobnost zrušení. Součet pravděpodobností všech možných výsledků je, jak jsme již ukázali, roven 1.
Rozdělení lze stručněji zapsat jako vektor. Například P(Flight) = <0.6, 0.3, 0.1>. Aby byl tento zápis srozumitelný, musí být pořadí hodnot pevné; zde včas, zpožděný, zrušený.
Nezávislost
Nezávislost znamená, že výskyt jedné události neovlivňuje pravděpodobnost druhé. U dvou kostek je například výsledek každé nezávislý na druhé. Čtyřka na první neovlivní výsledek druhé. Naproti tomu ranní oblačnost a odpolední déšť jsou závislé události: po zataženém ránu je odpolední déšť pravděpodobnější.
Matematicky jsou události a a b nezávislé právě tehdy, když se jejich společná pravděpodobnost rovná součinu pravděpodobností a a b: P(a ∧ b) = P(a)P(b).
Bayesovo pravidlo
Bayesovo pravidlo se v teorii pravděpodobnosti běžně používá k výpočtu podmíněné pravděpodobnosti. Slovy: pravděpodobnost b za podmínky a se rovná pravděpodobnosti a za podmínky b vynásobené pravděpodobností b a dělené pravděpodobností a.
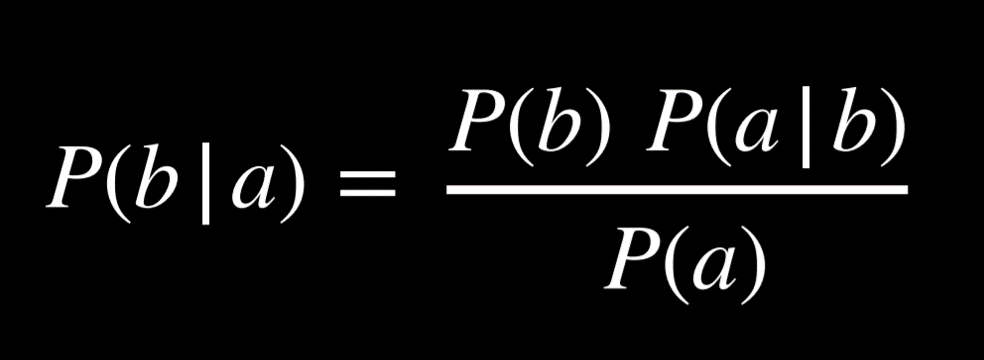
Chceme například spočítat pravděpodobnost odpoledního deště při ranní oblačnosti, tedy P(rain | clouds). Začneme těmito informacemi:
- 80 % deštivých odpolední začíná zataženým ránem, tedy P(clouds | rain).
- 40 % dní má zatažené ráno, tedy P(clouds).
- 10 % dní má deštivé odpoledne, tedy P(rain).
Bayesovým pravidlem získáme (0.1)(0.8)/(0.4) = 0.2. Pravděpodobnost odpoledního deště při zataženém ránu je tedy 20 %.
Znalost P(a | b), P(a) a P(b) umožňuje vypočítat P(b | a). Je to užitečné: z pravděpodobnosti viditelného účinku při neznámé příčině P(visible effect | unknown cause) můžeme určit pravděpodobnost neznámé příčiny při pozorovaném účinku P(unknown cause | visible effect). Při zdravotnických studiích například testujeme osoby s nemocí a zjišťujeme, jak často ji test zachytí, čímž určíme P(medical test results | disease). Z toho lze vypočítat P(disease | medical test results), užitečnou diagnostickou informaci.
Společná pravděpodobnost
Společná pravděpodobnost je pravděpodobnost současného výskytu více událostí.
Uvažujme příklad s pravděpodobností ranní oblačnosti a odpoledního deště.
| C = cloud | C = ¬cloud |
|---|---|
| 0.4 | 0.6 |
| R = rain | R = ¬rain |
|---|---|
| 0.1 | 0.9 |
Z těchto údajů ještě nelze určit, zda ranní oblačnost souvisí s pravděpodobností odpoledního deště. Potřebujeme společné pravděpodobnosti všech možných kombinací obou veličin. Můžeme je zapsat do této tabulky:
| R = rain | R = ¬rain | |
|---|---|---|
| C = cloud | 0.08 | 0.32 |
| C = ¬cloud | 0.02 | 0.58 |
Nyní máme informace o společném výskytu událostí. Pravděpodobnost, že určitého dne bude ráno zataženo a odpoledne zaprší, je 0.08. Pravděpodobnost jasného rána bez odpoledního deště je 0.58.
Ze společných pravděpodobností odvodíme podmíněnou pravděpodobnost. Pokud nás například zajímá rozdělení ranní oblačnosti při odpoledním dešti, platí P(C | rain) = P(C, rain)/P(rain). Doplňující poznámka: v pravděpodobnosti lze zaměnit čárku a ∧, tedy P(C, rain) = P(C ∧ rain). Slovy: společnou pravděpodobnost deště a oblačnosti dělíme pravděpodobností deště.
Ve zmíněné rovnici můžeme P(rain) chápat jako určitou konstantu, kterou se násobí P(C, rain). Zapíšeme tedy P(C, rain)/P(rain) = αP(C, rain), neboli α<0.08, 0.02>. Vyčleněním α dostaneme poměr možných hodnot C při odpoledním dešti: oblačnost a nepřítomnost oblačnosti mají poměr 0.08 : 0.02. Hodnoty 0.08 a 0.02 nedávají součet 1; protože však jde o rozdělení náhodné veličiny C, musí jej dávat. Proto hodnoty normalizujeme výpočtem α tak, aby α0.08 + α0.02 = 1. Nakonec získáme P(C | rain) = <0.8, 0.2>.
Pravidla pravděpodobnosti
- Negace: P(¬a) = 1 - P(a). Součet pravděpodobností všech možných světů je 1 a komplementární literály a a ¬a zahrnují všechny možné světy.
-
Princip inkluze a exkluze: P(a ∨ b) = P(a) + P(b) - P(a ∧ b). Světy, kde platí a nebo b, zahrnují světy s pravdivým a a světy s pravdivým b. Světy, kde jsou pravdivé oba výroky, tím však započítáme dvakrát. Abychom překryv odstranili, jednou jejich pravděpodobnost odečteme.
Příklad nad rámec přednášky: předpokládejme, že v 80 % dní jím zmrzlinu a v 70 % dní sušenky. Pokud bychom pravděpodobnost, že dnes sním zmrzlinu nebo sušenky, tedy P(ice cream ∨ cookies), počítali bez odečtení P(ice cream ∧ cookies), chybně bychom dostali 0.7 + 0.8 = 1.5. To odporuje axiomu, že pravděpodobnost leží mezi 0 a 1. Dny, kdy jsem snědl obojí, jsme započítali dvakrát. Oprava spočívá v jednom odečtení P(ice cream ∧ cookies).
- Marginalizace: P(a) = P(a, b) + P(a, ¬b). Události b a ¬b jsou disjunktní: pravděpodobnost jejich současného výskytu je 0 a součet jejich pravděpodobností je 1. Pokud nastane a, může b buď nastat, nebo nenastat. Součet společných pravděpodobností a s b a a s ¬b tedy dává pravděpodobnost samotného a.
Marginalizaci lze pro náhodné veličiny vyjádřit takto:
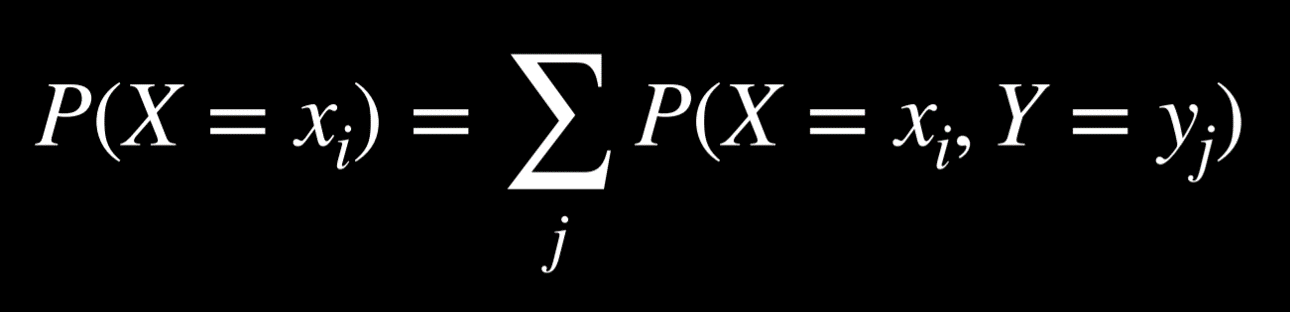
Levá strana znamená „pravděpodobnost, že náhodná veličina X má hodnotu xᵢ“. U dřívější veličiny C jsou například možné hodnoty ranní oblačnost a žádná ranní oblačnost. Pravá strana vyjadřuje marginalizaci: P(X = xᵢ) je součet společných pravděpodobností xᵢ s každou možnou hodnotou náhodné veličiny Y. Například P(C = cloud) = P(C = cloud, R = rain) + P(C = cloud, R = ¬rain) = 0.08 + 0.32 = 0.4.
- Podmínění: P(a) = P(a | b)P(b) + P(a | ¬b)P(¬b). Jde o obdobu marginalizace. Pravděpodobnost a odpovídá pravděpodobnosti a za podmínky b násobené pravděpodobností b, plus pravděpodobnosti a za podmínky ¬b násobené pravděpodobností ¬b.
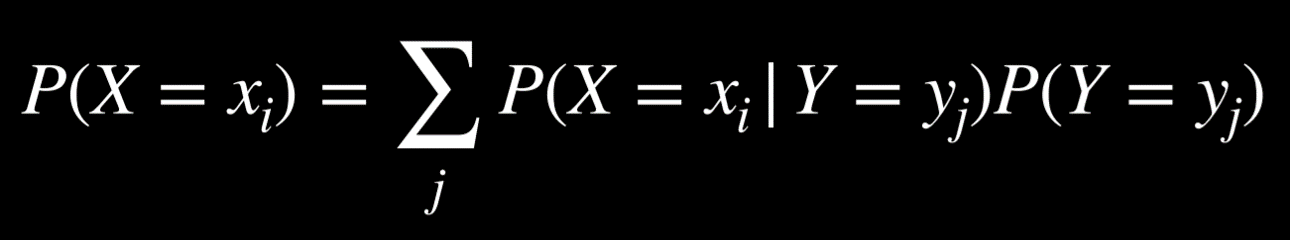
V tomto vzorci nabývá náhodná veličina X hodnoty xᵢ s pravděpodobností rovnou součtu pravděpodobností xᵢ podmíněných jednotlivými hodnotami Y, vynásobených pravděpodobnostmi těchto hodnot Y. To je přirozené, připomeneme-li si P(a | b) = P(a, b)/P(b). Vynásobením P(b) dostaneme P(a, b) a dále postupujeme stejně jako při marginalizaci.
Bayesovské sítě
Bayesovská síť je datová struktura reprezentující závislosti mezi náhodnými veličinami. Má následující vlastnosti:
- Jde o orientované grafy.
- Každý uzel grafu reprezentuje náhodnou veličinu.
- Šipka z X do Y znamená, že X je rodičem Y: rozdělení Y závisí na hodnotě X.
- Každý uzel X má rozdělení P(X | Parents(X)).
Uvažujme příklad Bayesovské sítě s veličinami ovlivňujícími, zda dorazíme včas na schůzku.
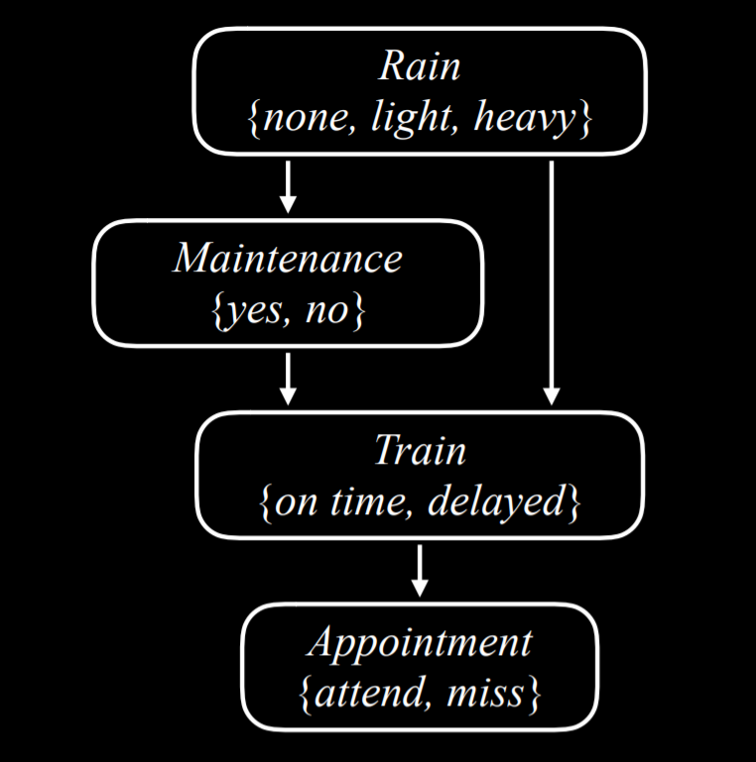
Popišme síť shora dolů:
-
Rain, tedy déšť, je kořenový uzel. Jeho rozdělení proto nezávisí na žádné předchozí události. V příkladu může nabývat hodnot {none, light, heavy}, tedy žádný, slabý a silný déšť, s tímto rozdělením:none light heavy 0.7 0.2 0.1 -
Maintenancereprezentuje údržbu železniční trati s hodnotami {yes, no}, tedy ano a ne. Jeho rodičem jeRain, což znamená, že déšť ovlivňuje rozdělení údržby.R yes no none 0.4 0.6 light 0.2 0.8 heavy 0.1 0.9 -
Trainreprezentuje vlak včas nebo se zpožděním, tedy {on time, delayed}. Směřují k němu šipky zMaintenanceiRain: oba uzly jsou jeho rodiči a jejich hodnoty ovlivňují rozděleníTrain.R M on time delayed none yes 0.8 0.2 none no 0.9 0.1 light yes 0.6 0.4 light no 0.7 0.3 heavy yes 0.4 0.6 heavy no 0.5 0.5 -
Appointmentreprezentuje účast či neúčast na schůzce hodnotami {attend, miss}. Jeho jediným rodičem jeTrain. Rodičovské uzly v Bayesovské síti zahrnují pouze přímé vztahy. Údržba sice ovlivňuje příjezd vlaku a příjezd vlaku ovlivňuje naši účast na schůzce, ale přímo naši šanci účasti ovlivňuje právě příjezd vlaku. To síť reprezentuje. Je-li například vlak včas, silný déšť ani údržba trati už v tomto modelu účast neovlivňují.T attend miss on time 0.9 0.1 delayed 0.6 0.4
Pokud chceme pravděpodobnost zmeškání schůzky při zpožděném vlaku, bez údržby a za slabého deště, tedy P(light, no, delayed, miss), počítáme P(light)P(no | light)P(delayed | light, no)P(miss | delayed). Jednotlivé pravděpodobnosti najdeme v uvedených rozděleních a jejich součinem získáme P(no, light, delayed, miss).
Odvozování
V minulé přednášce jsme odvozovali pomocí logického důsledku: z existujících informací jsme mohli s jistotou vyvodit nové. Nové informace lze odvozovat také pomocí pravděpodobností. Nezískáme tak jistotu, ale můžeme určit pravděpodobnostní rozdělení hodnot. Odvozování má více složek.
- Dotaz X: veličina, jejíž pravděpodobnostní rozdělení chceme vypočítat.
- Pozorované veličiny E: jedna nebo více veličin pozorovaných pro událost e. Můžeme například pozorovat slabý déšť, který nám pomůže spočítat pravděpodobnost zpoždění vlaku.
- Skryté veličiny Y: veličiny, které nejsou dotazem a nebyly ani pozorovány. Na nádraží například vidíme déšť, ale nevíme, zda dál probíhá údržba trati. Maintenance je proto v takové situaci skrytá veličina.
- Cíl: vypočítat P(X | e). Například rozdělení Train, tedy dotazované veličiny, na základě důkazu e že víme o slabém dešti.
Chceme například určit rozdělení Appointment, pokud víme, že slabě prší a neprobíhá údržba trati. Zjišťujeme pravděpodobnost účasti a neúčasti P(Appointment | light, no). Z části o společné pravděpodobnosti víme, že možné hodnoty lze vyjádřit poměrem: P(Appointment | light, no) zapíšeme jako αP(Appointment, light, no). Jak však rozdělení spočítáme, když jediným rodičem je Train, nikoli Rain nebo Maintenance? Použijeme marginalizaci. Hodnota P(Appointment, light, no) se rovná α[P(Appointment, light, no, delayed) + P(Appointment, light, no, on time)].
Odvozování výčtem
Odvozování výčtem určuje pravděpodobnostní rozdělení veličiny X při pozorovaném důkazu e a skrytých veličinách Y.
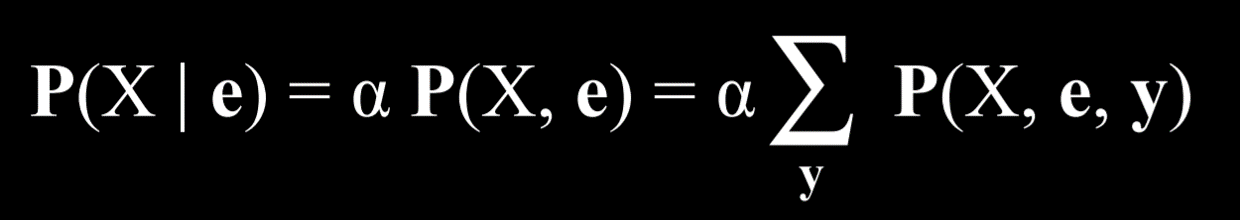
V rovnici X označuje dotazovanou veličinu, e pozorovaný důkaz, y všechny hodnoty skrytých veličin a α normalizuje výsledek tak, aby součet pravděpodobností byl 1. Slovy: rozdělení X za podmínky e odpovídá normalizovanému společnému rozdělení X a e. Získáme je součtem pravděpodobností X, e a y přes různé možné hodnoty skrytých veličin Y a následnou normalizací.
V Pythonu existuje více knihoven zjednodušujících pravděpodobnostní odvozování. Podíváme se na pomegranate a na to, jak uvedená data reprezentovat v kódu.
Nejprve vytvoříme uzly a každému přiřadíme pravděpodobnostní rozdělení.
from pomegranate import *

# Rain node has no parents
rain = Node(DiscreteDistribution({
    "none": 0.7,
    "light": 0.2,
    "heavy": 0.1
}), name="rain")

# Track maintenance node is conditional on rain
maintenance = Node(ConditionalProbabilityTable([
    ["none", "yes", 0.4],
    ["none", "no", 0.6],
    ["light", "yes", 0.2],
    ["light", "no", 0.8],
    ["heavy", "yes", 0.1],
    ["heavy", "no", 0.9]
], [rain.distribution]), name="maintenance")

# Train node is conditional on rain and maintenance
train = Node(ConditionalProbabilityTable([
    ["none", "yes", "on time", 0.8],
    ["none", "yes", "delayed", 0.2],
    ["none", "no", "on time", 0.9],
    ["none", "no", "delayed", 0.1],
    ["light", "yes", "on time", 0.6],
    ["light", "yes", "delayed", 0.4],
    ["light", "no", "on time", 0.7],
    ["light", "no", "delayed", 0.3],
    ["heavy", "yes", "on time", 0.4],
    ["heavy", "yes", "delayed", 0.6],
    ["heavy", "no", "on time", 0.5],
    ["heavy", "no", "delayed", 0.5],
], [rain.distribution, maintenance.distribution]), name="train")

# Appointment node is conditional on train
appointment = Node(ConditionalProbabilityTable([
    ["on time", "attend", 0.9],
    ["on time", "miss", 0.1],
    ["delayed", "attend", 0.6],
    ["delayed", "miss", 0.4]
], [train.distribution]), name="appointment")
Potom vytvoříme model: přidáme všechny uzly a hranami popíšeme rodičovské vztahy. Připomeňme, že Bayesovská síť je orientovaný graf složený z uzlů a šipek mezi nimi.
# Create a Bayesian Network and add states
model = BayesianNetwork()
model.add_states(rain, maintenance, train, appointment)

# Add edges connecting nodes
model.add_edge(rain, maintenance)
model.add_edge(rain, train)
model.add_edge(maintenance, train)
model.add_edge(train, appointment)

# Finalize model
model.bake()
Pro zjištění pravděpodobnosti určité události nyní spustíme model s požadovanými hodnotami. Zde se ptáme na pravděpodobnost současné nepřítomnosti deště i údržby, příjezdu vlaku včas a účasti na schůzce.
# Calculate probability for a given observation
probability = model.probability([["none", "no", "on time", "attend"]])

print(probability)
Program lze také použít k určení rozdělení všech veličin při známém pozorovaném důkazu. V následujícím případě víme, že vlak měl zpoždění. S touto informací vypočítáme a vypíšeme rozdělení Rain, Maintenance a Appointment.
# Calculate predictions based on the evidence that the train was delayed
predictions = model.predict_proba({
    "train": "delayed"
})

# Print predictions for each node
for node, prediction in zip(model.states, predictions):
    if isinstance(prediction, str):
        print(f"{node.name}: {prediction}")
    else:
        print(f"{node.name}")
        for value, probability in prediction.parameters[0].items():
            print(f"    {value}: {probability:.4f}")
Uvedený kód použil odvozování výčtem. Tento výpočet je však neefektivní, zejména při mnoha veličinách. Můžeme proto místo přesné inference použít přibližnou. Ztratíme část přesnosti vypočtených pravděpodobností, často je však tato nepřesnost zanedbatelná. Získáme za to metodu, která lépe zvládá rostoucí velikost úlohy.
Vzorkování
Jednou technikou přibližného odvozování je vzorkování. Každé veličině vybereme hodnotu podle jejího rozdělení. Začneme příkladem nad rámec přednášky a potom přejdeme k příkladu z přednášky.
Pro vytvoření rozdělení vzorkováním kostky můžeme opakovaně házet a zapisovat výsledky. Předpokládejme 600 hodů. Spočítáme počet jedniček, který by měl být přibližně 100, a stejně postupujeme u hodnot 2–6. Každý počet vydělíme celkovým počtem hodů. Získáme přibližné rozdělení: přesná pravděpodobnost každé hodnoty je 1/6, ale přesně takový výsledek nejspíš nevyjde; dostaneme hodnoty blízké.
Příklad z přednášky: při vzorkování Rain vznikne none s pravděpodobností 0.7, light s 0.2 a heavy s 0.1. Předpokládejme výsledek none. Maintenance potom vzorkujeme z rozdělení podmíněného právě Rain = none, protože tuto hodnotu už vzorek obsahuje. Takto projdeme všechny uzly a získáme jeden vzorek. Opakováním vytváříme rozdělení. Chceme-li například P(Train = on time), spočítáme vzorky s vlakem včas a vydělíme celkovým počtem vzorků. Tím získáme přibližnou pravděpodobnost.
Můžeme odpovídat i na otázky s podmíněním, například P(Rain = light | Train = on time). Ignorujeme vzorky, kde vlak nebyl včas. Mezi zbývajícími spočítáme ty s Rain = light a vydělíme celkovým počtem vzorků s Train = on time.
Vzorkovací funkce může v kódu vypadat jako generate_sample:
import pomegranate

from collections import Counter

from model import model

def generate_sample():

    # Mapping of random variable name to sample generated
    sample = {}

    # Mapping of distribution to sample generated
    parents = {}

    # Loop over all states, assuming topological order
    for state in model.states:

        # If we have a non-root node, sample conditional on parents
        if isinstance(state.distribution, pomegranate.ConditionalProbabilityTable):
            sample[state.name] = state.distribution.sample(parent_values=parents)

        # Otherwise, just sample from the distribution alone
        else:
            sample[state.name] = state.distribution.sample()

        # Keep track of the sampled value in the parents mapping
        parents[state.distribution] = sample[state.name]

    # Return generated sample
    return sample
Pro P(Appointment | Train = delayed), tedy rozdělení účasti při zpoždění vlaku, postupujeme takto:
# Rejection sampling
# Compute distribution of Appointment given that train is delayed
N = 10000
data = []

# Repeat sampling 10,000 times
for i in range(N):

    # Generate a sample based on the function that we defined earlier
    sample = generate_sample()

    # If, in this sample, the variable of Train has the value delayed, save the sample. Since we are interested interested in the probability distribution of Appointment given that the train is delayed, we discard the sampled where the train was on time.
    if sample["train"] == "delayed":
        data.append(sample["appointment"])

# Count how many times each value of the variable appeared. We can later normalize by dividing the results by the total number of saved samples to get the approximate probabilities of the variable that add up to 1.
print(Counter(data))
Vážení věrohodností (likelihood weighting)
V předchozím příkladu jsme vzorky neodpovídající známému důkazu zahazovali. To je neefektivní. Jednou alternativou je vážení věrohodností s následujícími kroky:
- Nejprve pevně nastavte hodnoty pozorovaných veličin.
- Ostatní veličiny vzorkujte podle podmíněných pravděpodobností v Bayesovské síti.
- Každému vzorku přiřaďte váhu podle jeho věrohodnosti: pravděpodobnosti všech pozorovaných důkazů.
Pokud například pozorujeme, že vlak přijel včas, začneme vzorkovat stejně jako dříve. Vybereme Rain podle jeho rozdělení a potom Maintenance. U Train však vždy nastavíme pozorovanou hodnotu, zde on time. Následně vzorkujeme Appointment podle rozdělení podmíněného vlakem včas. Hotovému vzorku přiřadíme váhu podle podmíněné pravděpodobnosti pozorované veličiny při vybraných rodičích. Pokud jsme tedy vybrali slabý déšť a údržbu, váhou bude P(Train = on time | light, yes).
Markovovy modely
Dosud jsme zkoumali pravděpodobnost při známých pozorovaných informacích. Čas jsme v tomto přístupu nijak nereprezentovali. Mnoho úloh, například předpověď, však na čase závisí. Zavedeme proto novou veličinu X a měníme ji podle události: Xₜ je současná událost, Xₜ₊₁ následující atd. K předpovídání budoucích událostí použijeme Markovovy modely.
Markovův předpoklad
Markovův předpoklad říká, že současný stav závisí pouze na pevném konečném počtu předchozích stavů. To je důležité. Při předpovědi počasí bychom teoreticky mohli využít všechny údaje z minulého roku. Je to však nepraktické kvůli potřebnému výpočetnímu výkonu i kvůli pravděpodobné neznalosti podmíněné pravděpodobnosti zítřejšího počasí při znalosti počasí před 365 dny. Markovovým předpokladem omezíme uvažované předchozí stavy, například počet minulých dní, a učiníme úlohu zvládnutelnou. Výsledný odhad může být hrubší, často však pro naše potřeby stačí. Můžeme dokonce použít model založený pouze na poslední události, například předpovídat zítřejší počasí podle dnešního.
Markovův řetězec
Markovův řetězec je posloupnost náhodných veličin, jejichž rozdělení odpovídají Markovovu předpokladu. Každá událost tedy nastává na základě pravděpodobností podmíněných předchozí událostí.
K sestavení Markovova řetězce potřebujeme přechodový model popisující rozdělení následující události podle možných hodnot současné události.
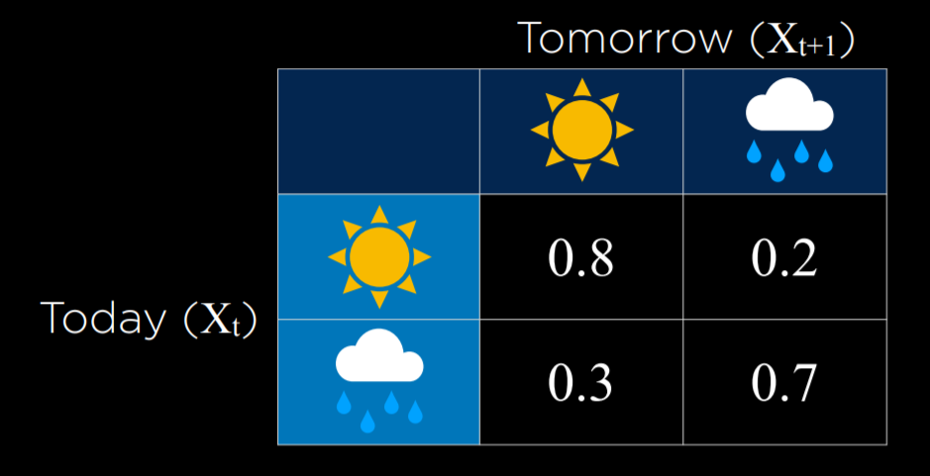
V tomto příkladu je při dnešním slunečném počasí pravděpodobnost slunečného zítřka 0.8. Slunečný den totiž pravděpodobněji následuje po slunečném dni. Pokud dnes prší, pravděpodobnost zítřejšího deště je 0.7, protože deštivé dny častěji následují po sobě. Tento přechodový model umožňuje vzorkovat Markovův řetězec. Začneme slunečným či deštivým dnem a vybereme následující den podle podmíněných pravděpodobností při dnešním počasí. Pozítří podmíníme zítřkem a tak dále. Vznikne řetězec:
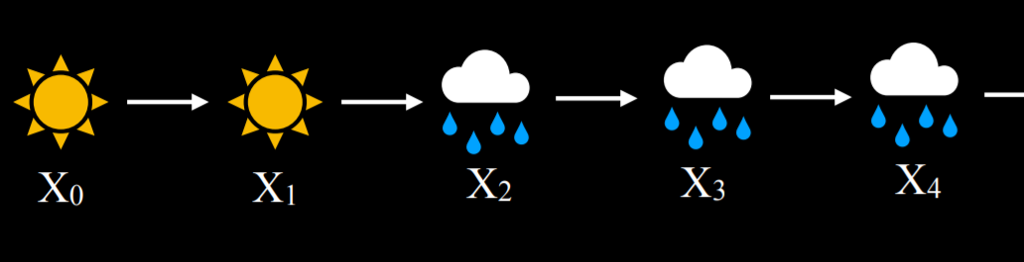
S tímto řetězcem můžeme odpovídat například na otázku „Jaká je pravděpodobnost čtyř po sobě jdoucích deštivých dní?“ Takto lze řetězec implementovat v kódu:
from pomegranate import *

# Define starting probabilities
start = DiscreteDistribution({
    "sun": 0.5,
    "rain": 0.5
})

# Define transition model
transitions = ConditionalProbabilityTable([
    ["sun", "sun", 0.8],
    ["sun", "rain", 0.2],
    ["rain", "sun", 0.3],
    ["rain", "rain", 0.7]
], [start])

# Create Markov chain
model = MarkovChain([start, transitions])

# Sample 50 states from chain
print(model.sample(50))
Skryté Markovovy modely
Skrytý Markovův model je model systému, jehož skryté stavy vytvářejí pozorované události. AI někdy má určité měření světa, ale nemá přístup k jeho přesnému stavu. Stav světa pak označujeme jako skrytý stav a dostupná data jako pozorování. Příklady:
- U robota zkoumajícího neznámé území je skrytým stavem poloha a pozorováním údaje jeho senzorů.
- Při rozpoznávání řeči jsou skrytým stavem vyslovená slova a pozorováním zvukové průběhy.
- Při měření zapojení uživatele na webu je skrytým stavem míra zapojení a pozorováním analytické údaje webu či aplikace.
Použijeme následující příklad. AI chce odvodit počasí, tedy skrytý stav, má však pouze vnitřní kameru zaznamenávající, kolik lidí si přineslo deštník. Pravděpodobnosti reprezentuje tento senzorový, také nazývaný emisní, model:
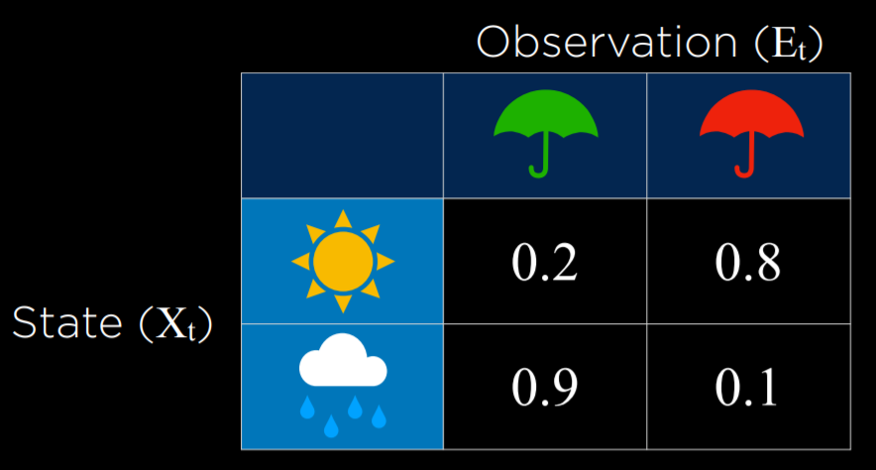
V modelu si lidé za slunečna s největší pravděpodobností do budovy deštník nepřinesou. Za deště je velmi pravděpodobné, že si ho přinesou. Z pozorování deštníků tedy můžeme s rozumnou pravděpodobností odhadovat venkovní počasí.
Markovův předpoklad senzoru
Předpokládáme, že veličina pozorovaného důkazu závisí pouze na odpovídajícím stavu. V modelu například předpokládáme, že přinášení deštníku do kanceláře závisí jen na počasí. To nemusí plně odpovídat skutečnosti: svědomitější lidé, kteří se vyhýbají dešti, mohou nosit deštník všude i za slunečna. Znalost osobností by modelu přidala další údaje. Markovův předpoklad senzoru je však ignoruje a předpokládá, že pozorování ovlivňuje pouze skrytý stav.
Skrytý Markovův model můžeme zobrazit jako řetězec se dvěma vrstvami. Horní vrstva X představuje skrytý stav; dolní vrstva E důkaz, tedy dostupná pozorování.
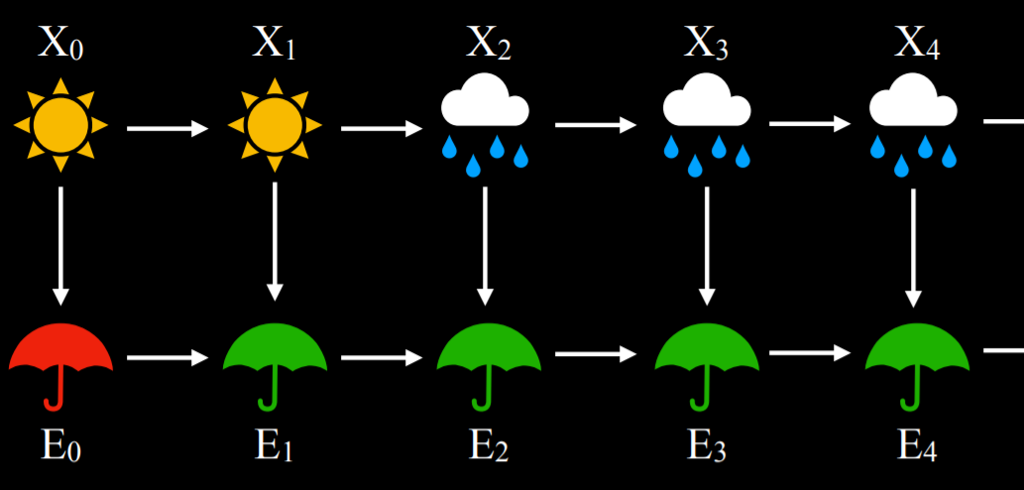
Skryté Markovovy modely umožňují plnit více úloh:
- Filtrování: z pozorování od začátku do současnosti vypočítáme rozdělení současného stavu. Z údajů o deštnících od začátku sledování do dneška například určíme rozdělení, zda dnes prší.
- Predikce: z pozorování od začátku do současnosti vypočítáme rozdělení budoucího stavu.
- Vyhlazování: z pozorování od začátku do současnosti vypočítáme rozdělení minulého stavu. Například pravděpodobnost včerejšího deště při dnešních pozorovaných deštnících.
- Nejpravděpodobnější vysvětlení: z pozorování od začátku do současnosti určíme nejpravděpodobnější posloupnost událostí.
Úlohu nejpravděpodobnějšího vysvětlení lze použít například při rozpoznávání řeči. Z několika zvukových průběhů AI odvodí nejpravděpodobnější posloupnost slov či slabik, které je vytvořily. Následuje implementace skrytého Markovova modelu v Pythonu pro tuto úlohu:
from pomegranate import *

# Observation model for each state
sun = DiscreteDistribution({
    "umbrella": 0.2,
    "no umbrella": 0.8
})

rain = DiscreteDistribution({
    "umbrella": 0.9,
    "no umbrella": 0.1
})

states = [sun, rain]

# Transition model
transitions = numpy.array(
    [[0.8, 0.2], # Tomorrow's predictions if today = sun
     [0.3, 0.7]] # Tomorrow's predictions if today = rain
)

# Starting probabilities
starts = numpy.array([0.5, 0.5])

# Create the model
model = HiddenMarkovModel.from_matrix(
    transitions, states, starts,
    state_names=["sun", "rain"]
)
model.bake()
Náš model obsahuje jak senzorový, tak přechodový model. Pro skrytý Markovův model potřebujeme oba. Následující kód uvádí posloupnost pozorování, zda lidé přinesli do budovy deštník. Model z této posloupnosti vypočítá a vypíše nejpravděpodobnější vysvětlení: posloupnost počasí, která pozorování nejpravděpodobněji vytvořila.
from model import model

# Observed data
observations = [
    "umbrella",
    "umbrella",
    "no umbrella",
    "umbrella",
    "umbrella",
    "umbrella",
    "umbrella",
    "no umbrella",
    "no umbrella"
]

# Predict underlying states
predictions = model.predict(observations)
for prediction in predictions:
    print(model.states[prediction].name)
Program zde vypíše rain, rain, sun, rain, rain, rain, rain, sun, sun. Jde o nejpravděpodobnější posloupnost počasí při známých pozorováních lidí s deštníkem a bez něj.