Přednáška 6: Jazyk
Tyto poznámky odpovídají nové verzi přednášky 6 zveřejněné 14. srpna 2023. Pokud jste sledovali předchozí verzi a chcete její poznámky, klikněte zde.
Jazyk
Dosud jsme museli úkoly a data upravovat tak, aby je AI dokázala zpracovat. Dnes se podíváme, jak vytvořit AI pro zpracování lidského jazyka.
Zpracování přirozeného jazyka (Natural Language Processing, NLP) zahrnuje všechny úlohy, v nichž AI přijímá lidský jazyk jako vstup. Příklady těchto úloh jsou:
- automatické shrnování: AI dostane text a vytvoří jeho shrnutí.
- extrakce informací: AI dostane korpus textů a získá z něj data.
- rozpoznání jazyka: AI dostane text a určí, v jakém je jazyce.
- strojový překlad: AI dostane text ve zdrojovém jazyce a vytvoří překlad do cílového jazyka.
- rozpoznávání pojmenovaných entit: AI z textu získá názvy entit, například názvy společností.
- rozpoznávání řeči: AI dostane mluvenou řeč a zapíše stejná slova do textu.
- klasifikace textu: AI dostane text a zařadí jej do určitého typu.
- rozlišení významu slova: AI musí zvolit správný význam víceznačného slova. Například anglické bank může znamenat finanční instituci i břeh řeky.
Syntax a sémantika
Syntax je struktura věty. Jako rodilí mluvčí nějakého jazyka obvykle bez obtíží tvoříme gramatické věty a rozpoznáváme negramatické věty jako nesprávné. Například anglická věta „Just before nine o’clock Sherlock Holmes stepped briskly into the room“ je gramatická; česky znamená „Těsně před devátou Sherlock Holmes svižně vstoupil do pokoje“. Naproti tomu „Just before Sherlock Holmes nine o’clock stepped briskly the room“ je negramatická. Syntax může být současně gramatická a nejednoznačná, například ve větě „I saw the man with the telescope“: „Viděl jsem muže s dalekohledem“. Viděl jsem muže, který měl dalekohled, nebo jsem muže viděl pomocí dalekohledu? Aby AI dokázala lidskou řeč rozebírat a vytvářet, musí zvládnout syntax.
Sémantika je význam slov a vět. Věta „Just before nine o’clock Sherlock Holmes stepped briskly into the room“ má jinou syntaktickou stavbu než „Sherlock Holmes stepped briskly into the room just before nine o’clock“, ale jejich obsah je prakticky totožný: „Těsně před devátou Sherlock Holmes svižně vstoupil do pokoje“ a „Sherlock Holmes svižně vstoupil do pokoje těsně před devátou“. Podobně věta „A few minutes before nine, Sherlock Holmes walked quickly into the room“, tedy „Pár minut před devátou Sherlock Holmes rychle vešel do pokoje“, používá jiná slova, ale má velmi podobný význam. Věta navíc může být zcela gramatická a přesto nesmyslná. Chomského příkladem je „Colorless green ideas sleep furiously“: „Bezbarvé zelené myšlenky zuřivě spí“. Aby AI dokázala lidskou řeč rozebírat a vytvářet, musí zvládnout i sémantiku.
Bezkontextová gramatika
Formální gramatika je soustava pravidel pro vytváření vět v jazyce. U bezkontextové gramatiky abstrahujeme od významu textu a pomocí formálních pravidel vyjadřujeme strukturu věty. Uvažujme následující příklad:
- She saw the city. (Viděla město.)
Jde o jednoduchou gramatickou větu. Chceme vytvořit syntaktický strom, který vyjádří její strukturu.
Nejprve každému slovu přiřadíme slovní druh. V této zjednodušené gramatice označujeme She a city značkou N pro jmenné výrazy. Saw je sloveso, označené V. The je determinátor, který určuje následující podstatné jméno jako určité nebo neurčité; označíme jej D. Větu tedy můžeme přepsat takto:
- N V D N
Dosud jsme každé slovo nahradili jeho slovním druhem a odhlédli od konkrétního významu. Slova ve větě jsou ovšem propojena, a pro pochopení věty potřebujeme rozumět i těmto vztahům. Jmenná fráze neboli noun phrase (NP) je skupina slov spojená s podstatným jménem. V této větě tvoří samostatnou jmennou frázi she. Další jmennou frázi tvoří the city, tedy determinátor a podstatné jméno. Slovesná fráze neboli verb phrase (VP) je skupina slov spojená se slovesem. Samo saw může být slovesnou frází, ale slovesnou frázi tvoří také saw the city. Zde se skládá ze slovesa a jmenné fráze, kterou dále tvoří determinátor a podstatné jméno. Celou větu, označenou S, tedy můžeme vyjádřit následovně:
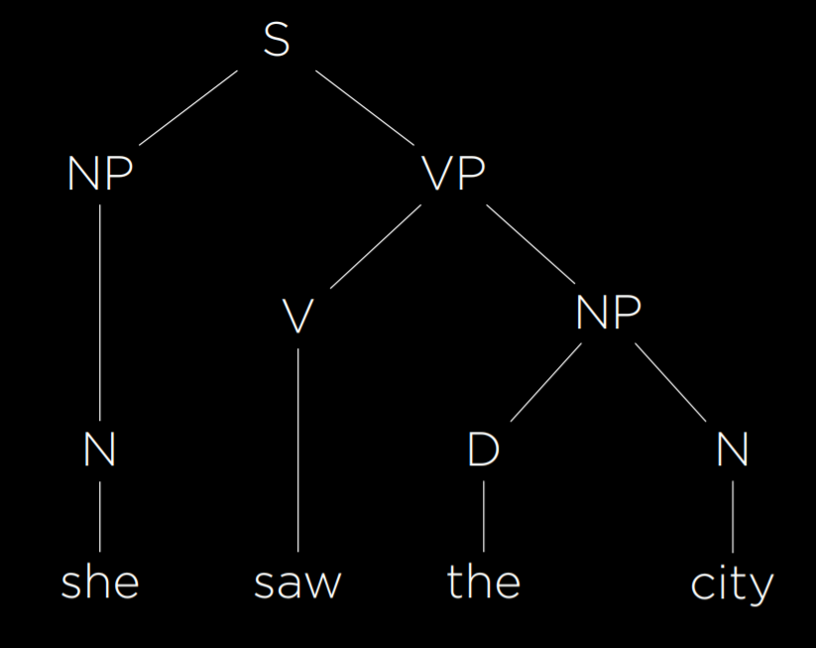
Pomocí formální gramatiky může AI reprezentovat strukturu vět. Popsaná gramatika obsahuje dost pravidel pro jednoduchou větu výše. Abychom vyjádřili složitější věty, musíme přidat další pravidla.
nltk
Jak tomu v Pythonu často bývá, popsaný princip už implementuje několik knihoven. Jednou z nich je nltk, zkratka Natural Language Toolkit. Pro analýzu předchozí věty předáme algoritmu tato gramatická pravidla:
import nltk

grammar = nltk.CFG.fromstring("""
    S -> NP VP

    NP -> D N | N
    VP -> V | V NP

    D -> "the" | "a"
    N -> "she" | "city" | "car"
    V -> "saw" | "walked"
""")

parser = nltk.ChartParser(grammar)
Podobně jako předtím určujeme, které součásti mohou být obsaženy v jiných. Věta může obsahovat jmennou a slovesnou frázi. Fráze se dále mohou skládat z jiných frází, podstatných jmen, sloves a dalších složek. Každý slovní druh nakonec zahrnuje konkrétní slova daného jazyka.
sentence = input("Sentence: ").split()
try:
    for tree in parser.parse(sentence):
        tree.pretty_print()
        tree.draw()
except ValueError:
    print("No parse tree possible.")
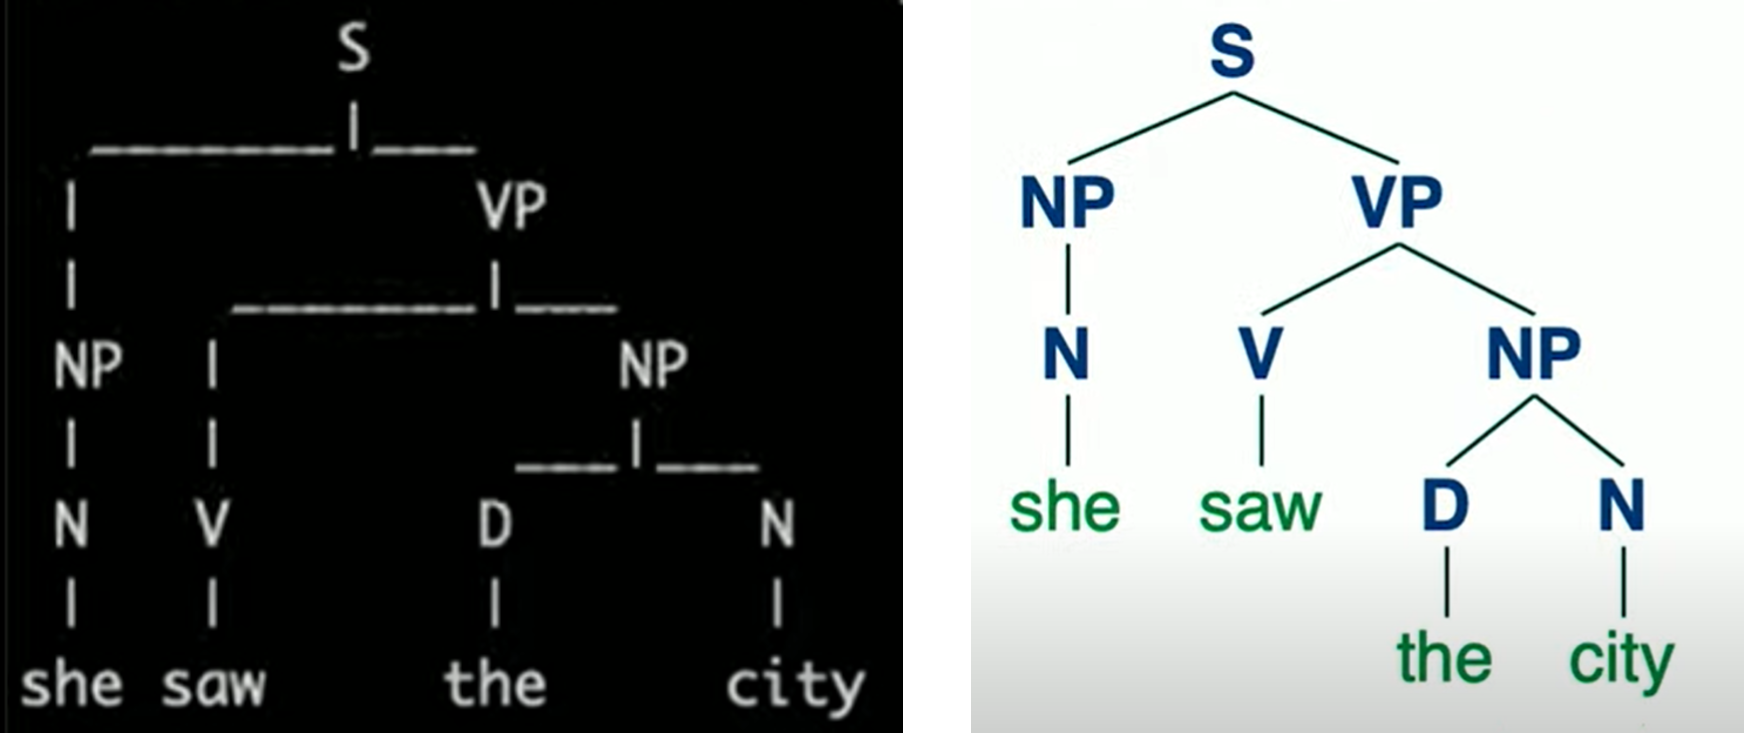
Po předání vstupní věty rozdělené na seznam slov funkce vypíše výsledný syntaktický strom pomocí pretty_print a vytvoří také grafické zobrazení pomocí draw.
n-gramy
n-gram je posloupnost n položek z textu. V znakovém n-gramu jsou položkami znaky, ve slovním n-gramu slova. Unigram, bigram a trigram jsou posloupnosti jedné, dvou a tří položek. V následující anglické větě jsou první tři trigramy „how often have“, „often have I“ a „have I said“.
„How often have I said to you that when you have eliminated the impossible whatever remains, however improbable, must be the truth?“ Český význam: „Kolikrát jsem vám říkal, že když vyloučíte nemožné, to, co zbývá, ať jakkoli nepravděpodobné, musí být pravda?“
n-gramy pomáhají při zpracování textu. AI možná nikdy neviděla celou větu, ale její části, například „have I said“, už pravděpodobně viděla. Některá slova se vyskytují společně častěji než jiná, a proto lze s určitou pravděpodobností předpovídat další slovo. Například telefon navrhuje slova podle rozdělení pravděpodobností odvozeného z posledních několika napsaných slov. Rozdělení věty na n-gramy je tedy užitečný krok při zpracování přirozeného jazyka.
Tokenizace
Tokenizace znamená rozdělení posloupnosti znaků na části, tedy tokeny. Tokeny mohou být slova i věty; podle toho mluvíme o slovní tokenizaci nebo větné tokenizaci. Tokenizaci potřebujeme při práci s n-gramy, protože ty jsou posloupnostmi tokenů. Začít můžeme rozdělením textu na slova podle mezer. Tento postup ale není dokonalý: získáme i slova s připojenou interpunkcí, například „remains,“. Interpunkci můžeme odstranit, tím ovšem vznikají další obtíže, třeba se slovy obsahujícími apostrof, jako „o’clock“, nebo spojovník, jako „pearl-grey“. Některá interpunkce navíc přispívá ke struktuře věty, například tečky. Musíme rozlišit tečku ve zkratce „Mr.“ od tečky na konci věty. Řešení těchto otázek patří do procesu tokenizace. Jakmile máme tokeny, můžeme pracovat s n-gramy.
Markovovy modely
Jak jsme probírali v předchozích přednáškách, Markovovy modely tvoří uzly, jejichž hodnoty mají rozdělení pravděpodobností závislé na konečném počtu předchozích uzlů. Markovovy modely lze použít ke generování textu. Model trénujeme na textu a stanovíme pravděpodobnosti dalších tokenů podle předcházejících slov v n-gramu. Například při práci s trigramy může model po prvních dvou slovech vybrat třetí z rozdělení pravděpodobností závislého na těchto dvou slovech. Potom zvolí čtvrté slovo podle druhého a třetího. Implementaci takového modelu pomocí nltk najdete ve zdrojovém souboru generator.py, kde se model učí vytvářet věty připomínající Shakespeara. Markovovy modely tak mohou vytvářet text, který bývá gramatický a povrchně připomíná lidský jazyk. Tyto věty však postrádají skutečný význam a záměr.
Model bag-of-words
Bag-of-words reprezentuje text jako neuspořádanou kolekci slov. Ignoruje syntax a zohledňuje pouze slova ve větě. Tento přístup pomáhá u některých klasifikačních úloh, například analýzy sentimentu. Jiným příkladem je rozlišování běžných e-mailů od spamu. Analýzou sentimentu můžeme například zařazovat recenze výrobků jako pozitivní nebo negativní. Uvažujme tyto věty:
- „My grandson loved it! So much fun!“ („Mému vnukovi se to moc líbilo! Tolik zábavy!“)
- „Product broke after a few days.“ („Výrobek se po několika dnech rozbil.“)
- „One of the best games I’ve played in a long time.“ („Jedna z nejlepších her, které jsem za dlouhou dobu hrál.“)
- „Kind of cheap and flimsy, not worth it.“ („Působí levně a chatrně, nestojí to za to.“)
Pouze ze slov, bez ohledu na gramatiku, vidíme, že věty 1 a 3 jsou pozitivní: obsahují „loved“, „fun“ a „best“, tedy zalíbení, zábavu a hodnocení nejlepší. Věty 2 a 4 jsou negativní: „broke“, „cheap“ a „flimsy“ znamenají rozbitý, levný a chatrný.
Naivní Bayesův klasifikátor
Naivní Bayesův klasifikátor lze použít pro analýzu sentimentu s modelem bag-of-words. Ptáme se: „Jaká je pravděpodobnost, že věta je pozitivní či negativní, pokud známe její slova?“ Jde o podmíněnou pravděpodobnost. Připomeňme si proto Bayesovo pravidlo z přednášky 2:
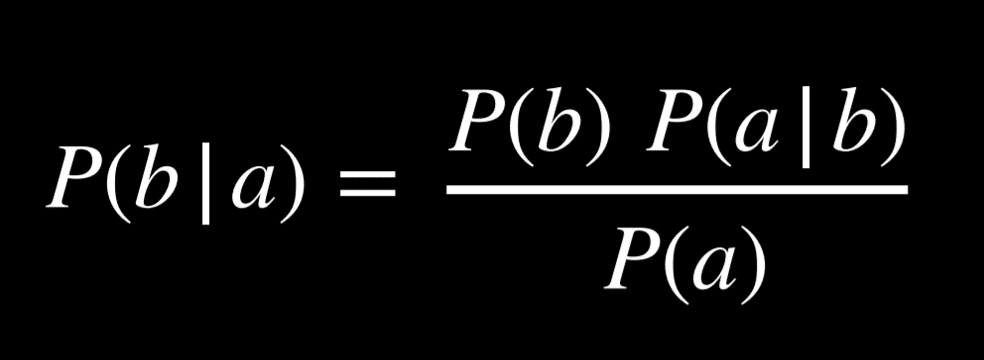
Tento vzorec nyní chceme použít pro výpočet P(sentiment | text), například P(positive | „my grandson loved it“). Začneme tokenizací vstupu a získáme P(positive | „my“, „grandson“, „loved“, „it“). Přímým použitím Bayesova pravidla dostaneme P(„my“, „grandson“, „loved“, „it“ | positive)*P(positive)/P(„my“, „grandson“, „loved“, „it“). Tento složitý výraz nám dá přesnou hodnotu P(positive | „my“, „grandson“, „loved“, „it“). Slovo positive ve vzorcích znamená pozitivní sentiment.
Výraz však můžeme zjednodušit, pokud nám zatím stačí hodnota přímo úměrná P(positive | „my“, „grandson“, „loved“, „it“), nikoli přímo rovná této pravděpodobnosti. Protože výsledné rozdělení musí mít součet 1, můžeme hodnoty později normalizovat. Z předchozího výrazu tedy ponecháme pouze čitatele: P(„my“, „grandson“, „loved“, „it“ | positive)*P(positive). Původní poznámky dále připomínají vztah mezi podmíněnou a společnou pravděpodobností a uvádějí mezikrok P(positive, „my“, „grandson“, „loved“, „it“)*P(positive). Výpočet společné pravděpodobnosti je ale složitý, protože pravděpodobnost každého slova závisí i na předchozích slovech. Je nutné vypočítat P(positive)*P(„my“ | positive)*P(„grandson“ | positive, „my“)*P(loved | positive, „my“, „grandson“)*P(„it“ | positive, „my“, „grandson“, „loved“). Poznámka k překladu: V uvedeném mezikroku originálu je P(positive) zapsáno navíc. Správně už součin P(text | positive)*P(positive) tvoří společnou pravděpodobnost P(positive, text). Poslední řetězový rozklad v tomto odstavci má správnou podobu.
Zde používáme Bayesovo pravidlo „naivně“: předpokládáme, že pravděpodobnosti jednotlivých slov jsou při daném sentimentu nezávislé na ostatních slovech. Ve skutečnosti to obecně neplatí, ale i s touto nepřesností může naivní Bayesův klasifikátor poskytnout dobrý odhad sentimentu. Dostaneme P(positive)*P(„my“ | positive)*P(„grandson“ | positive)*P(„loved“ | positive)*P(„it“ | positive), což není tak obtížné vypočítat. P(positive) je počet všech pozitivních vzorků vydělený celkovým počtem vzorků. P(„loved“ | positive) je podle této ukázky počet pozitivních vzorků obsahujících „loved“ vydělený počtem pozitivních vzorků. V následujícím příkladu usmívající se a mračící se emoji nahrazují slova „pozitivní“ a „negativní“.
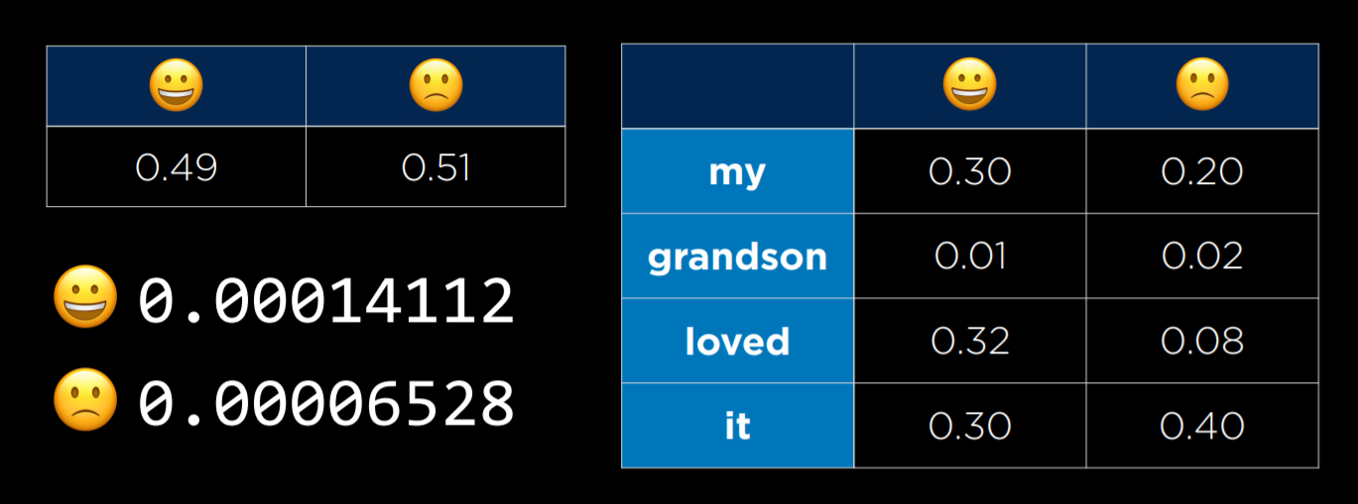
Vpravo vidíme tabulku podmíněných pravděpodobností výskytu jednotlivých slov ve větě za předpokladu, že věta je pozitivní nebo negativní. Malá tabulka vlevo ukazuje pravděpodobnost pozitivní a negativní věty. Vlevo dole jsou hodnoty po výpočtu. Zatím vyjadřují vzájemný poměr, ale samy o sobě nejsou normalizovanými pravděpodobnostmi. Po normalizaci dostaneme P(positive) = 0.6837 a P(negative) = 0.3163. Síla naivního Bayesova klasifikátoru spočívá v citlivosti na slova, která se v jednom typu vět vyskytují častěji než v druhém. V našem příkladu je „loved“ mnohem častější v pozitivních větách, takže celá věta vychází spíše pozitivně. Implementaci hodnocení sentimentu pomocí nltk najdete v sentiment.py.
Problém nastává, když se některé slovo v určitém typu vět vůbec nevyskytuje. Pokud například žádná pozitivní věta ve vzorku neobsahuje „grandson“, vyjde P(„grandson“ | positive) = 0 a při násobení dostaneme nulovou pravděpodobnost pozitivní věty. To ale neodpovídá skutečnosti: všechny věty zmiňující vnuky přece nejsou negativní. Jedním řešením je aditivní vyhlazování, kdy k jednotlivým hodnotám přidáme α. I k nulové hodnotě tak něco přičteme a celý součin nevynulujeme. Konkrétním případem je Laplaceovo vyhlazování, které přidává 1 a zachází s hodnotami tak, jako by každá byla pozorována alespoň jednou.
Reprezentace slov
Chceme v AI reprezentovat význam slov. Jak jsme už viděli, vstupy se dobře předávají v podobě čísel. Jednou možností je one-hot reprezentace: každé slovo má vektor s tolika položkami, kolik máme slov. Právě jedna položka je 1 a všechny ostatní 0. Slova se liší umístěním jedničky, takže každé má vlastní vektor. Větu „He wrote a book“, tedy „Napsal knihu“, můžeme reprezentovat čtyřmi vektory:
- [1, 0, 0, 0] (he = on)
- [0, 1, 0, 0] (wrote = napsal)
- [0, 0, 1, 0] (a = neurčitý člen)
- [0, 0, 0, 1] (book = kniha)
Ve světě čtyř slov tento postup funguje. U slovníku s 50 000 slovy ale dostaneme 50 000 vektorů, z nichž každý má délku 50 000, což je velmi neefektivní. Navíc neumíme vyjádřit podobnost slov jako „wrote“ a „authored“, tedy napsal a byl autorem. Proto používáme distribuovanou reprezentaci, kde je význam rozložen mezi více hodnot vektoru. Každý vektor má omezený počet hodnot, mnohem menší než 50 000, a může vypadat takto:
- [-0.34, -0.08, 0.02, -0.18, …] (he = on)
- [-0.27, 0.40, 0.00, -0.65, …] (wrote = napsal)
- [-0.12, -0.25, 0.29, -0.09, …] (a = neurčitý člen)
- [-0.23, -0.16, -0.05, -0.57, …] (book = kniha)
Takto můžeme každému slovu přiřadit jedinečné hodnoty a přitom používat kratší vektory. Podobnost slov navíc vyjádříme tím, jak moc se hodnoty jejich vektorů liší.
Anglický lingvista J. R. Firth formuloval myšlenku „You shall know a word by the company it keeps“: slovo poznáme podle slov, která mu dělají společnost. Význam slov tedy můžeme odvozovat z jejich okolí. Například větu „for ___ he ate“ může doplnit jen omezený okruh slov. Pravděpodobné možnosti jsou „breakfast“, „lunch“ a „dinner“, tedy snídaně, oběd a večeře. Z prostředí, v němž se slovo obvykle objevuje, můžeme usuzovat na jeho význam.
word2vec
word2vec je algoritmus pro vytváření distribuovaných reprezentací slov. Používá architekturu skip-gram, tedy architekturu neuronové sítě předpovídající kontext z cílového slova. Síť má vstupní jednotku pro každé cílové slovo. Jedna menší skrytá vrstva, například s 50 nebo 100 jednotkami, vytváří hodnoty distribuovaných reprezentací; tento počet lze měnit. Každá jednotka skryté vrstvy je propojena s každou jednotkou vstupní vrstvy. Výstupní vrstva vytváří slova, která se pravděpodobně vyskytují v podobném kontextu jako cílové slovo. Stejně jako minule se síť trénuje na trénovacích datech pomocí zpětného šíření chyby.
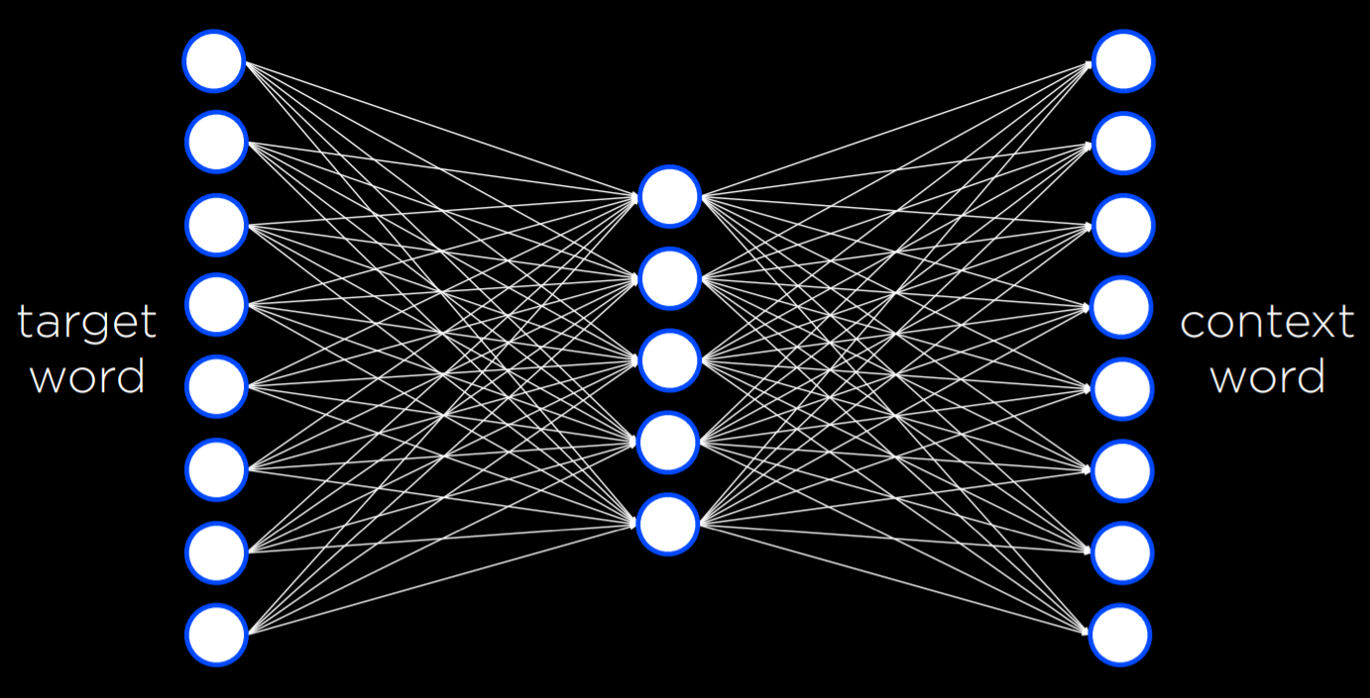
Tato síť se ukazuje jako poměrně účinná. Každé slovo je nakonec reprezentováno pouhým vektorem, tedy posloupností čísel. Například:
book: [-0.226776 -0.155999 -0.048995 -0.569774 0.053220 0.124401 -0.091108 -0.606255 -0.114630 0.473384 0.061061 0.551323 -0.245151 -0.014248 -0.210003 0.316162 0.340426 0.232053 0.386477 -0.025104 -0.024492 0.342590 0.205586 -0.554390 -0.037832 -0.212766 -0.048781 -0.088652 0.042722 0.000270 0.356324 0.212374 -0.188433 0.196112 -0.223294 -0.014591 0.067874 -0.448922 -0.290960 -0.036474 -0.148416 0.448422 0.016454 0.071613 -0.078306 0.035400 0.330418 0.293890 0.202701 0.555509 0.447660 -0.361554 -0.266283 -0.134947 0.105315 0.131263 0.548085 -0.195238 0.062958 -0.011117 -0.226676 0.050336 -0.295650 -0.201271 0.014450 0.026845 0.403077 -0.221277 -0.236224 0.213415 -0.163396 -0.218948 -0.242459 -0.346984 0.282615 0.014165 -0.342011 0.370489 -0.372362 0.102479 0.547047 0.020831 -0.202521 -0.180814 0.035923 -0.296322 -0.062603 0.232734 0.191323 0.251916 0.150993 -0.024009 0.129037 -0.033097 0.029713 0.125488 -0.018356 -0.226277 0.437586 0.004913]
Samotná čísla mnoho neříkají. Najdeme-li ale v korpusu slova s nejpodobnějšími vektory, můžeme vytvořit funkci vracející slova nejbližší slovu book, tedy kniha. V tomto modelu to budou book, books, essay, memoir, essays, novella, anthology, blurb, autobiography a audiobook: kniha, knihy, esej, paměti, eseje, novela, antologie, propagační anotace, autobiografie a audiokniha. To je pro počítač docela dobrý výsledek. Z čísel, která sama nenesou konkrétní význam, AI získá slova podobná slovu book významem, nikoli písmeny či zvukem. Podle rozdílů vektorů můžeme počítat i rozdíly mezi slovy. Například rozdíl king minus man, tedy král minus muž, připomíná rozdíl queen minus woman, tedy královna minus žena. Přičteme-li rozdíl mezi king a man k vektoru woman, nejbližším slovem výsledného vektoru je queen. Podobně přičtením rozdílu mezi ramen a japan k america získáme v této ukázce burritos. Neuronové sítě a distribuované reprezentace tak umožňují zachytit sémantické podobnosti slov a přibližují nás k systémům, které lidský jazyk zpracovávají a vytvářejí.
Neuronové sítě
Připomeňme si, že neuronová síť přijme vstup, zpracuje jej a vytvoří výstup. S trénovacími daty může převod vstupu na výstup postupně zpřesňovat. Neuronové sítě se běžně používají pro strojový překlad. V praxi ovšem překládáme celé věty či odstavce. Protože má věta pevnou velikost, narážíme na problém převodu jedné posloupnosti na jinou, jejichž velikosti nejsou pevně dané. AI chatbot podobně musí zpracovat posloupnost slov a vytvořit vhodnou výstupní posloupnost. Poznámka k překladu: Hlavní překlad zachovává původní anglickou formulaci „fixed size“ jako „pevná velikost“. Tato formulace je v popisovaném kontextu nepřesná: problém převodu posloupností se týká právě proměnlivé délky vstupních a výstupních posloupností.
Rekurentní neuronové sítě mohou síť spouštět opakovaně a udržovat stav s relevantními informacemi. První vstup vytvoří skrytý stav. Druhý vstup spolu s prvním skrytým stavem vytvoří v enkodéru nový skrytý stav. Postup se opakuje, dokud nepřijde koncový token. Pak začíná dekódování, které vytváří nové skryté stavy a výstupní slova až po další koncový token. Vznikají ale problémy. Při kódování musí být všechny informace ze vstupu uloženy do jediného konečného stavu. U dlouhých posloupností je to obtížné. Pomohlo by všechny skryté stavy nějak kombinovat. Navíc některé vstupní stavy či slova jsou důležitější než jiné. Lze zjistit, které jsou důležitější?
Attention: mechanismus pozornosti
Attention označuje schopnost sítě určit, které hodnoty jsou důležitější. U otázky „What is the capital of Massachusetts“, tedy „Jaké je hlavní město Massachusetts“, pomáhá síti rozhodnout, kterým částem vstupu věnovat pozornost při tvorbě odpovědi. Při vytváření posledního slova odpovědi jsou nejdůležitější výrazy „capital“ a „Massachusetts“. Síť vezme skóre pozornosti, vynásobí jím hodnoty příslušných skrytých stavů a výsledky sečte. Vznikne kontextový vektor, který dekodér použije při výpočtu posledního slova. Rekurentní sítě ale vyžadují postupné trénování slovo po slovu, což zabírá čas. S růstem velkých jazykových modelů trénování trvá déle a potřeba paralelního zpracování větších datových sad roste. Proto se objevila nová architektura.
Transformery
Transformer je typ architektury, v němž se vstupní slova zpracovávají současně. Každé vstupní slovo se zachytí jako kódovaná reprezentace. Protože se všechna slova předávají současně, jejich pořadí by se mohlo ztratit. Ke vstupům se proto přidává poziční kódování. Kódovaná reprezentace tak obsahuje slovo i jeho pozici. Dalším krokem je self-attention, tedy pozornost uvnitř stejné posloupnosti, která pomáhá určit kontext slova. Sítě často používají více takových kroků, aby kontext zachytily lépe. Tento proces se pro slova posloupnosti několikrát opakuje. Výsledkem jsou kódované reprezentace použitelné při dekódování.
Při dekódování prochází předchozí výstupní slovo a jeho poziční kódování více kroky self-attention a neuronovou sítí. Další kroky attention přijímají reprezentaci vytvořenou při kódování a předávají ji síti. Slova tak mohou zohledňovat ostatní slova. Architektura umožňuje paralelní zpracování a účinný výpočet.
Závěr kurzu
Umělou inteligenci jsme prozkoumali v mnoha souvislostech. U úloh prohledávání jsme sledovali, jak AI hledá řešení. Zkoumali jsme reprezentaci znalostí a odvozování nových znalostí. Pracovali jsme s nejistotou, když systém něco neví jistě. Při optimalizaci jsme maximalizovali a minimalizovali funkce. Ve strojovém učení jsme hledali vzorce v trénovacích datech. Poznali jsme neuronové sítě a způsob, jak pomocí vah převádějí vstupy na výstupy. Dnes jsme se věnovali jazyku a možnostem jeho zpracování počítačem. Dotkli jsme se teprve povrchu této oblasti. Doufáme, že se vám společná cesta líbila. Toto byl Úvod do umělé inteligence s Pythonem.